Estoy revisando y puliendo los borradores de artículos de ayuda de mi equipo y necesito definir un proceso de revisión. ¿Usas Humanly AI Detector & Humanizer, solo el detector con ediciones manuales o únicamente edición manual? ¿Por qué te funciona ese enfoque cuando la redacción debe mantener la precisión técnica?
Comparé los mismos pasajes en inglés, sin modificarlos, en las distintas herramientas los días 2 y 3 de octubre de 2026, contando solo las comprobaciones completadas. Los seis pasajes incluían un ensayo, un memorando, una paráfrasis y un relato personal ficticio generados por IA, además de un fragmento de Lewis Carroll y una versión ligeramente editada con IA. Llego tarde a este tema, así que quería separar los resultados reales de las páginas que solo ofrecían acceso. Algunas muestras estaban relacionadas entre sí, y ese fragmento humano no bastaba para representar la escritura habitual.
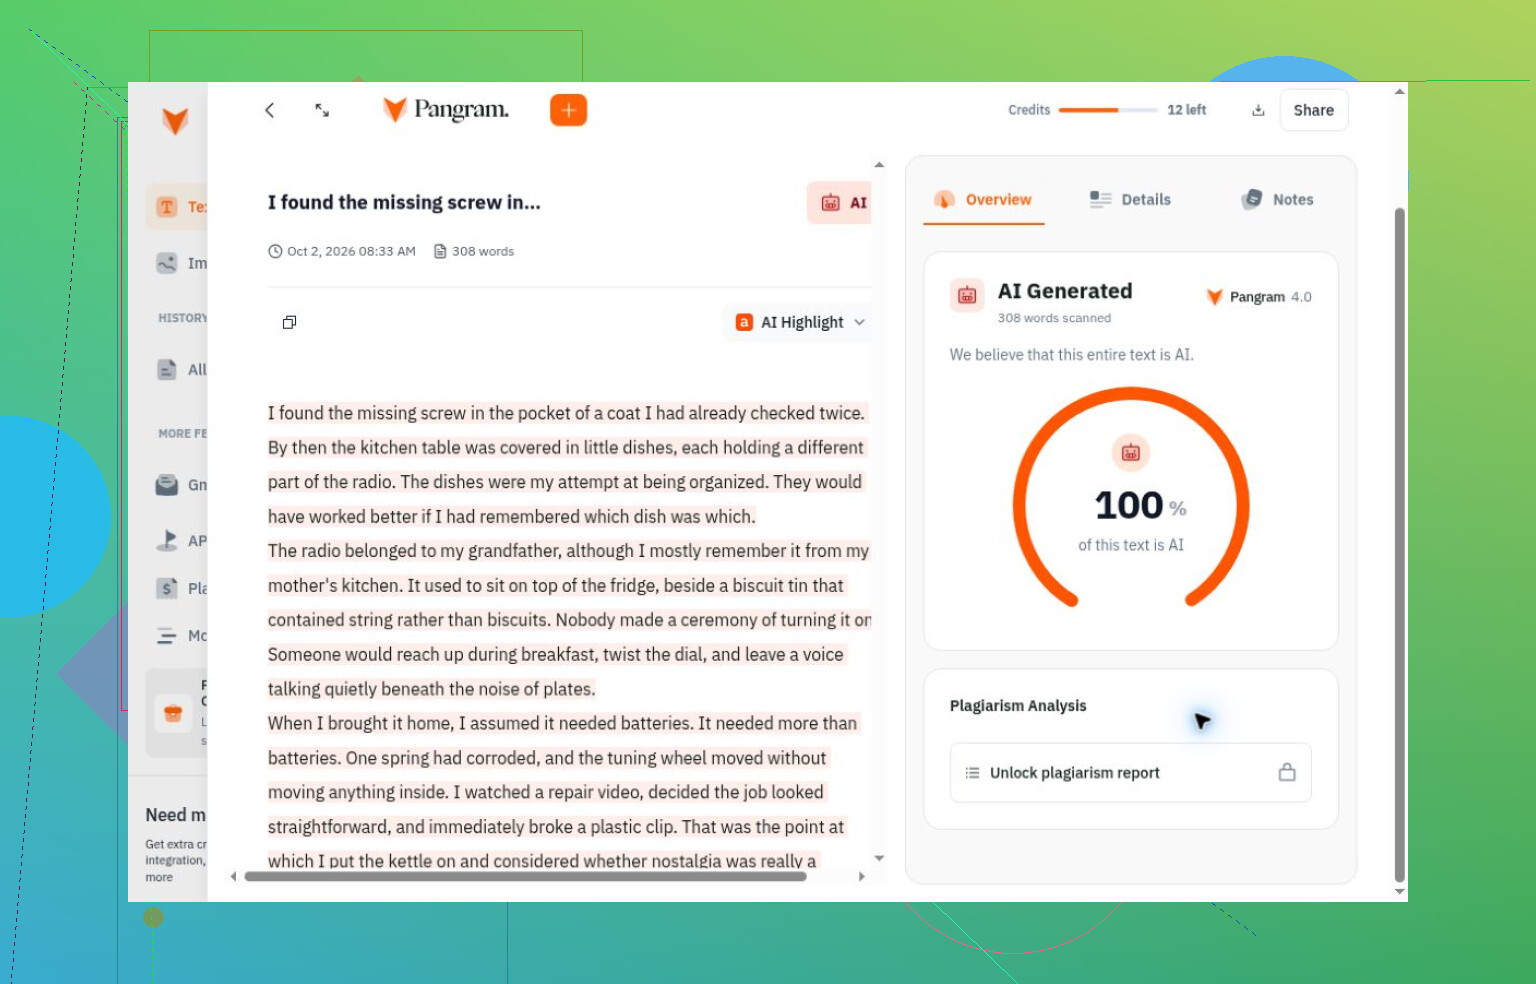
Conseguir acceso no era lo mismo que hacer pruebas
Tenía que recordarme constantemente que un problema de acceso no dice nada sobre la calidad de la detección.
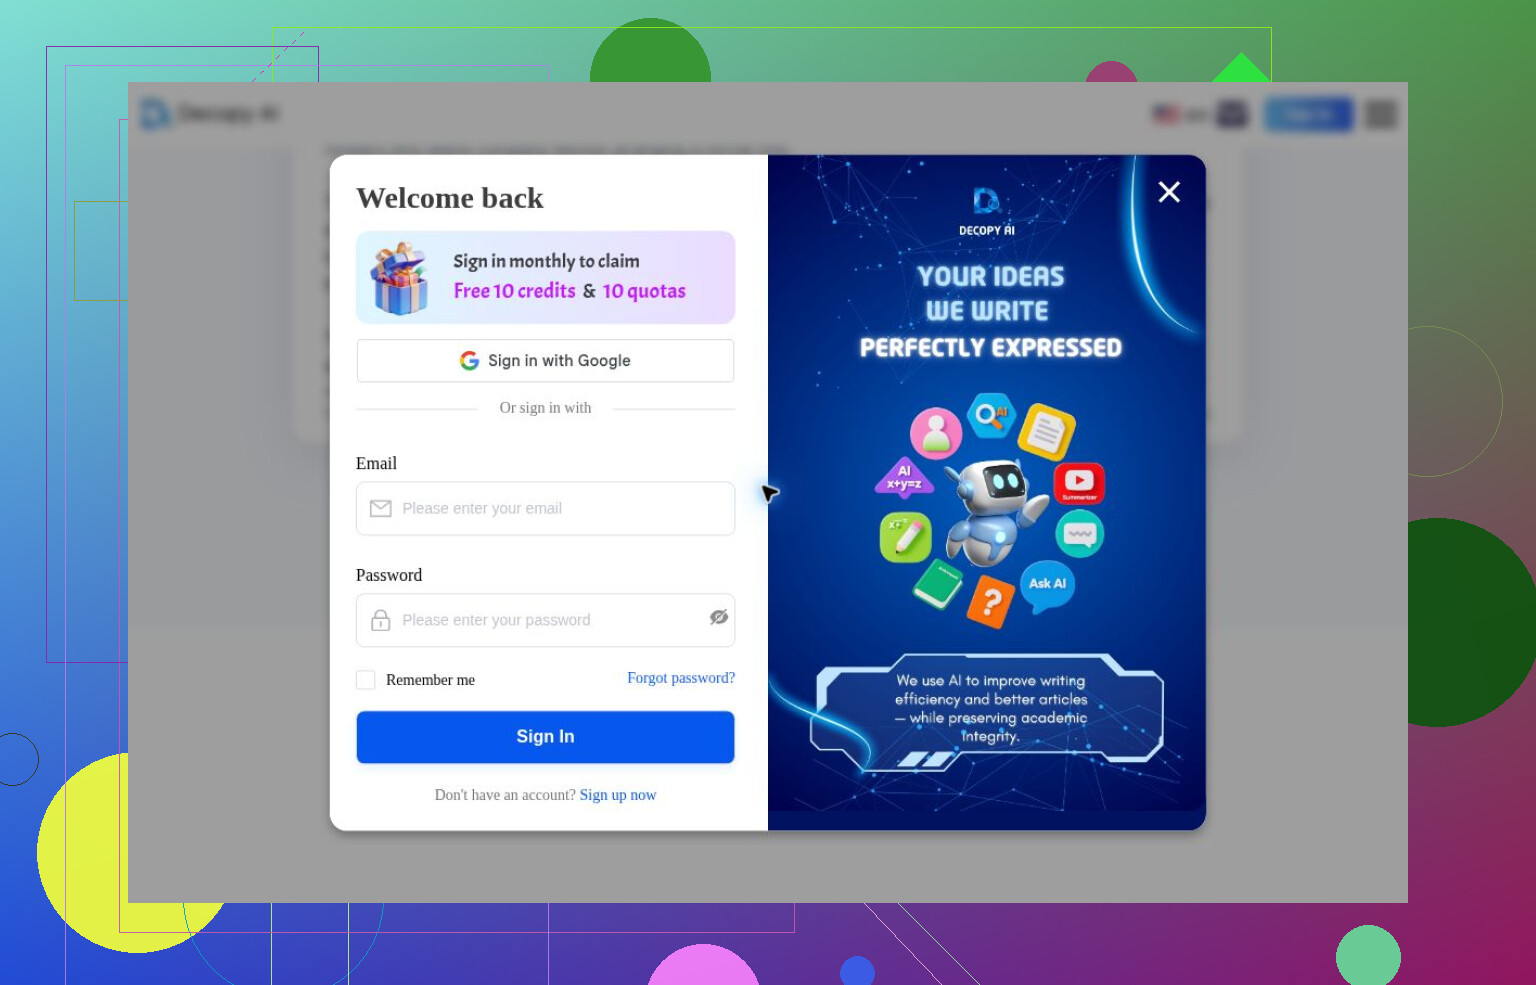
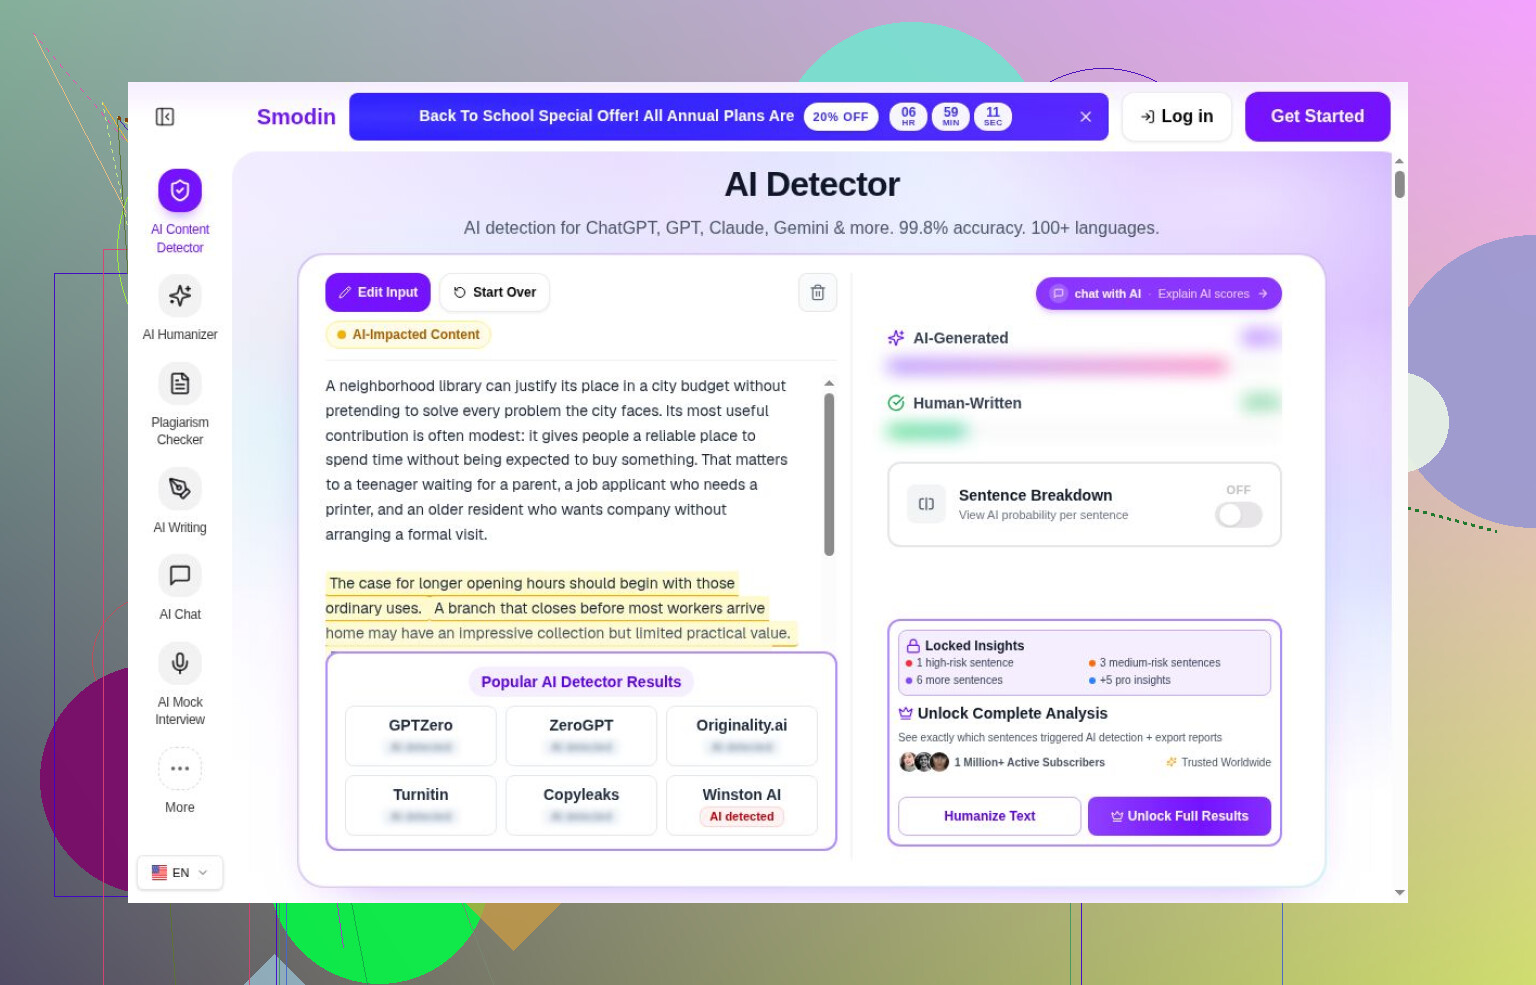
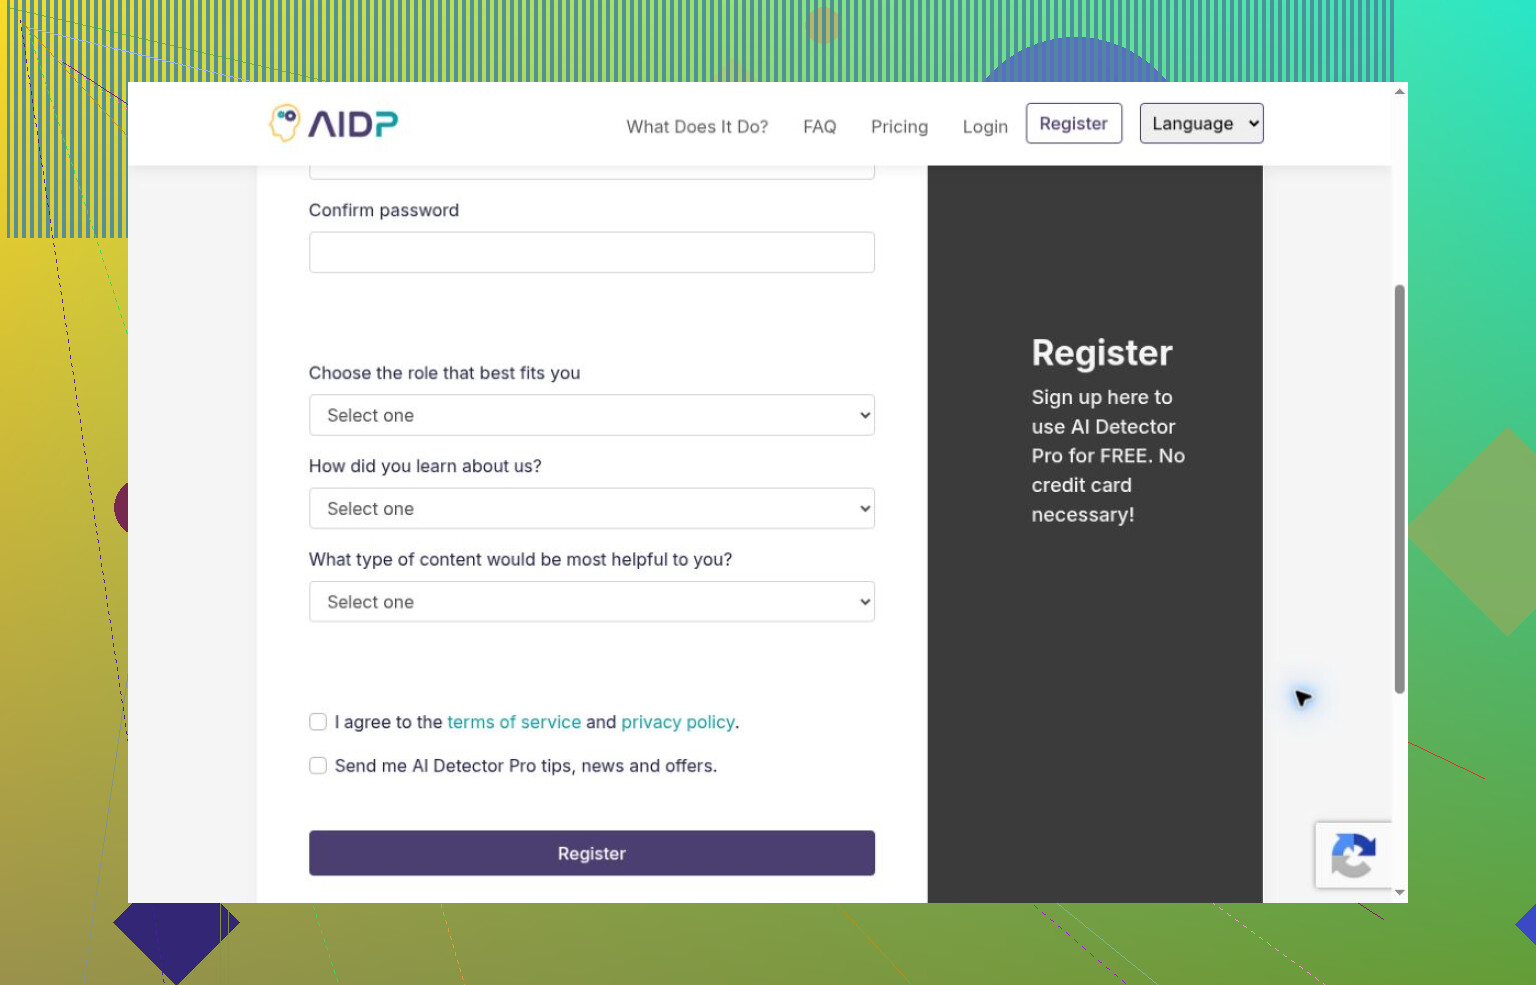
Decopy pidió iniciar sesión pese a anunciar detección básica sin registro. Smodin mostró fragmentos resaltados, pero ocultó los valores principales. AI Detector Pro exigió registrarse; con Winston AI no pasé de la inscripción al periodo de prueba. Sus cuotas de uso anunciadas quedaron sin verificar.
Copyleaks cargó una interfaz para invitados, pero me detuve por las condiciones de uso aplicables. Turnitin requería acceso institucional y una licencia adicional, que no tenía.
La demo de Hive que revisé aceptaba contenido multimedia en lugar de prosa. No probé su extensión para texto ni su API. ContentDetector.AI redirigió a la ficha de una extensión de Moxby, que no instalé. Con Humanly no pasé de la ficha de Apple: descarga gratuita, compras dentro de la aplicación indicadas y cuota de análisis desconocida.
Ninguna de estas herramientas debería figurar en una clasificación de precisión basada en esta comparación. Las vistas previas de los proveedores tampoco son resultados míos.
Las respuestas equivocadas fueron más instructivas
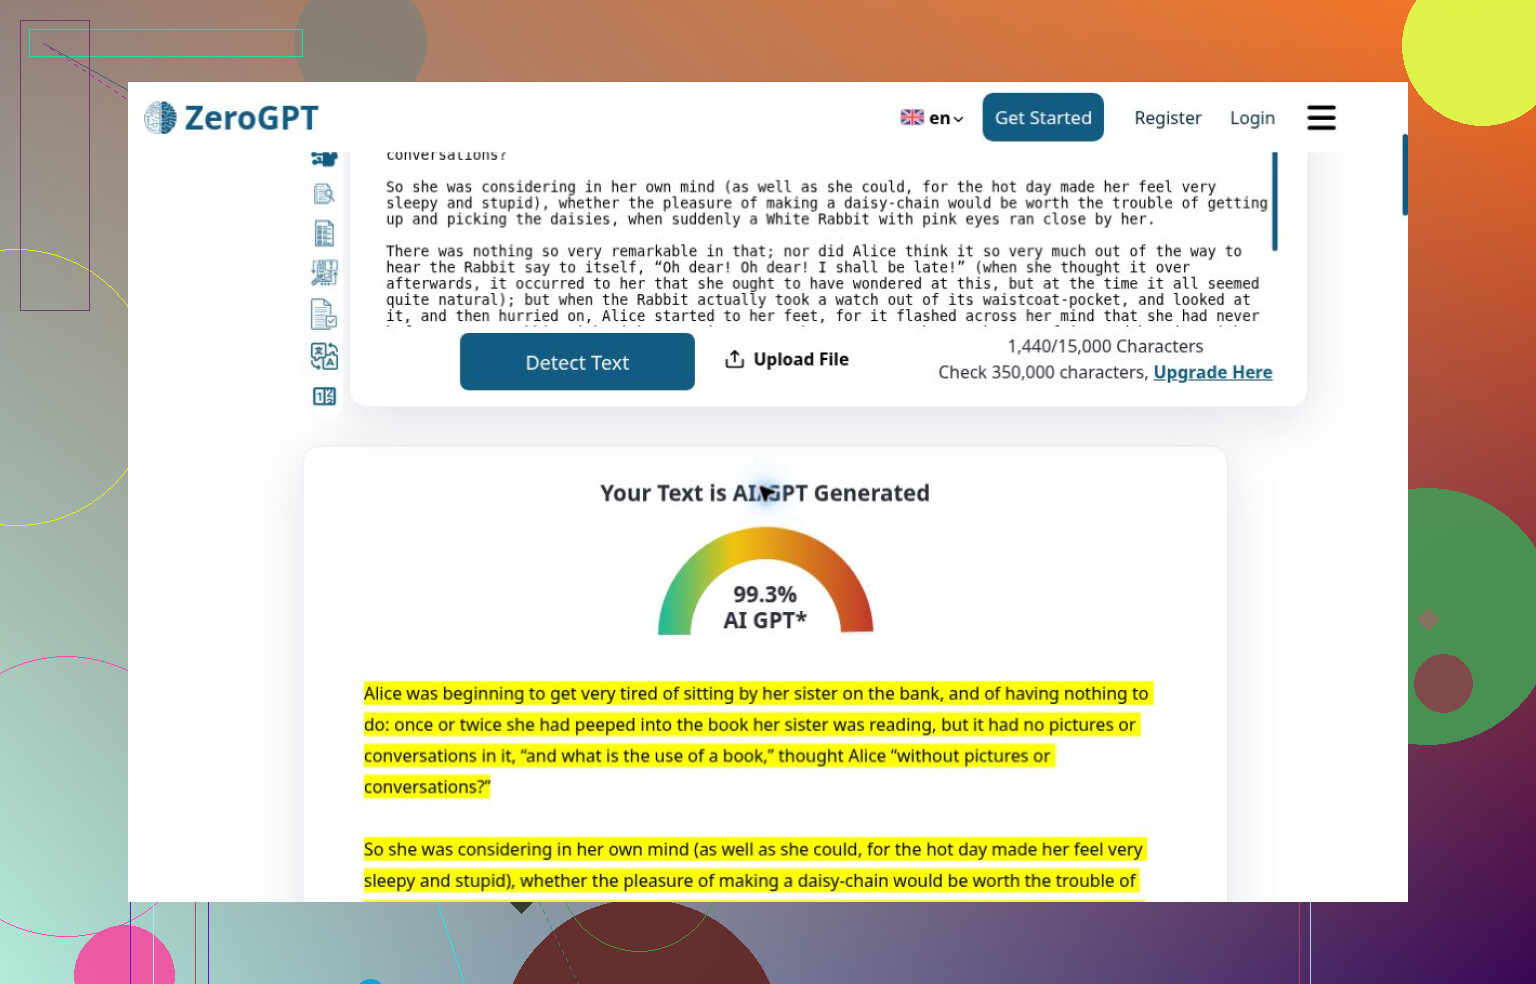
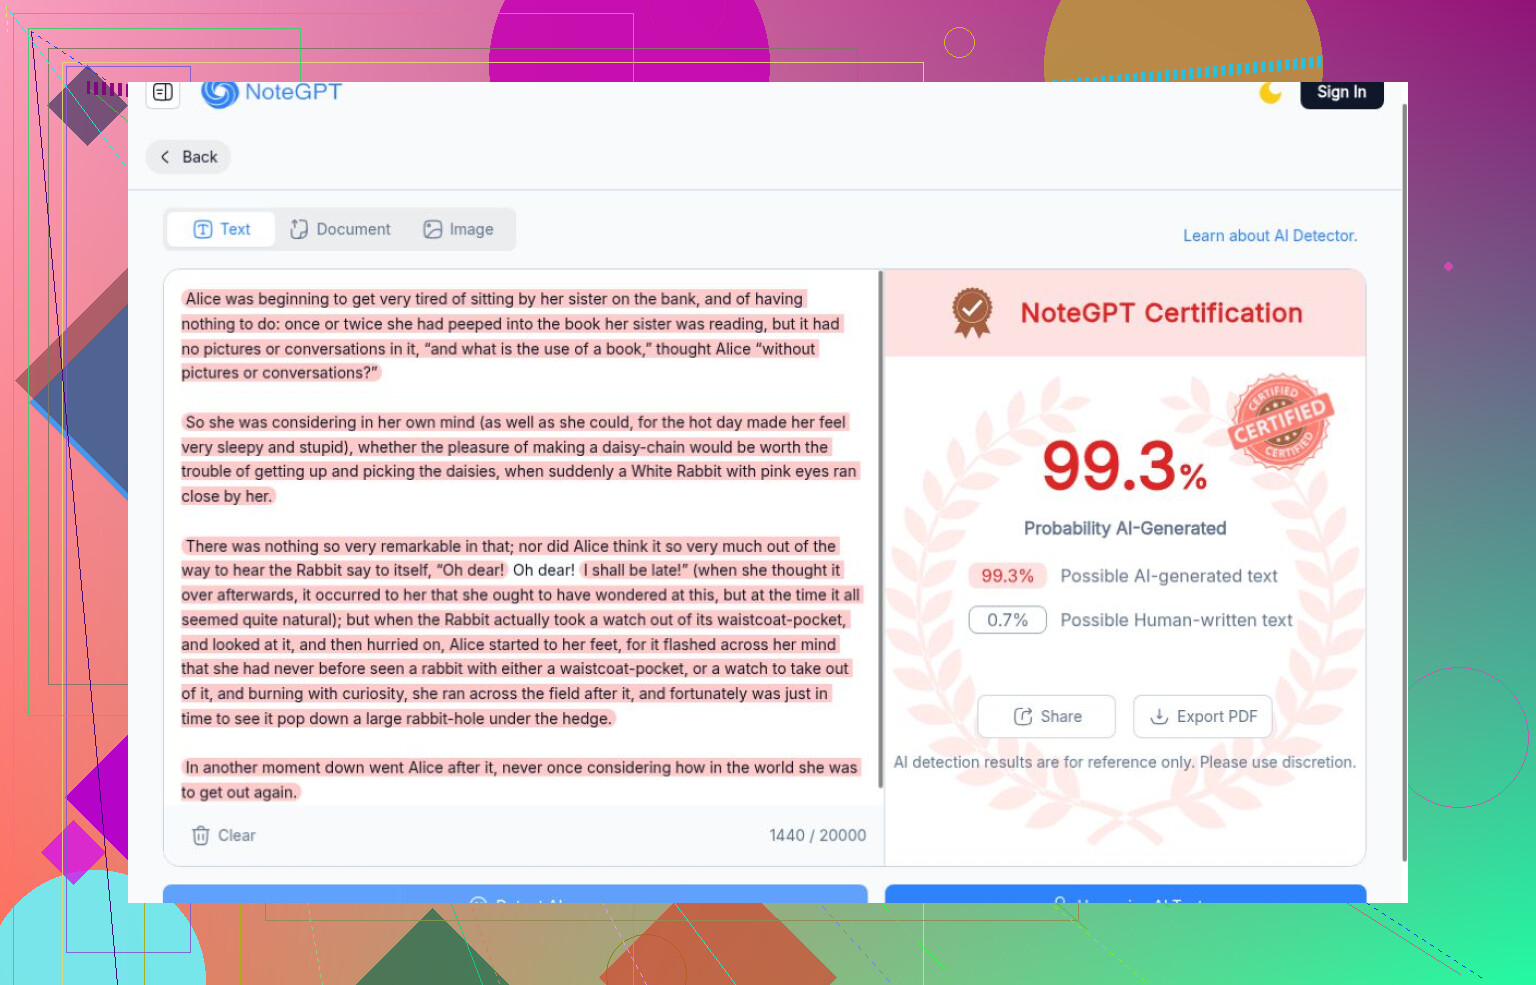
Al llegar tarde al tema, la muestra humana de control me resultó especialmente útil. ZeroGPT detectó todos los pasajes generados, pero calificó el de Carroll como más propio de una IA que cualquiera de ellos. NoteGPT también le dio a Carroll su puntuación más alta de IA. Que las puntuaciones sean similares no demuestra que compartan tecnología.
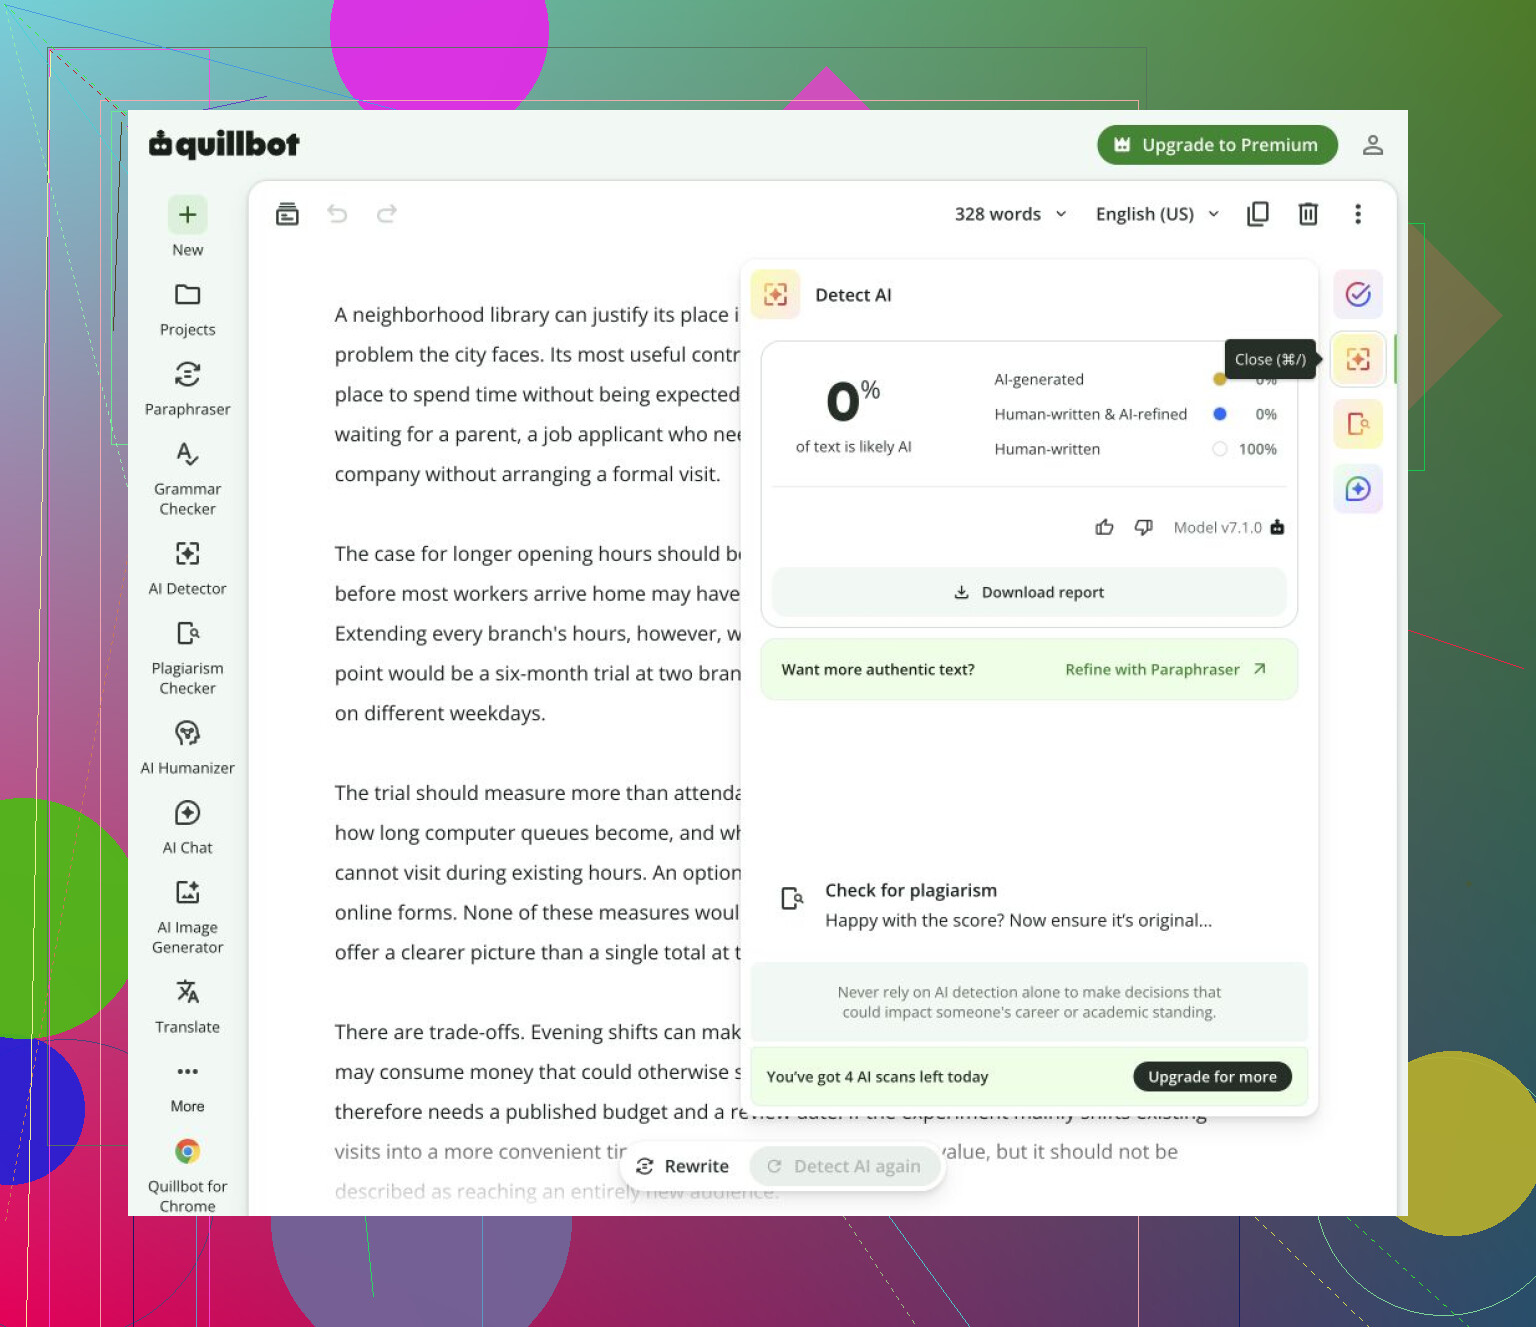
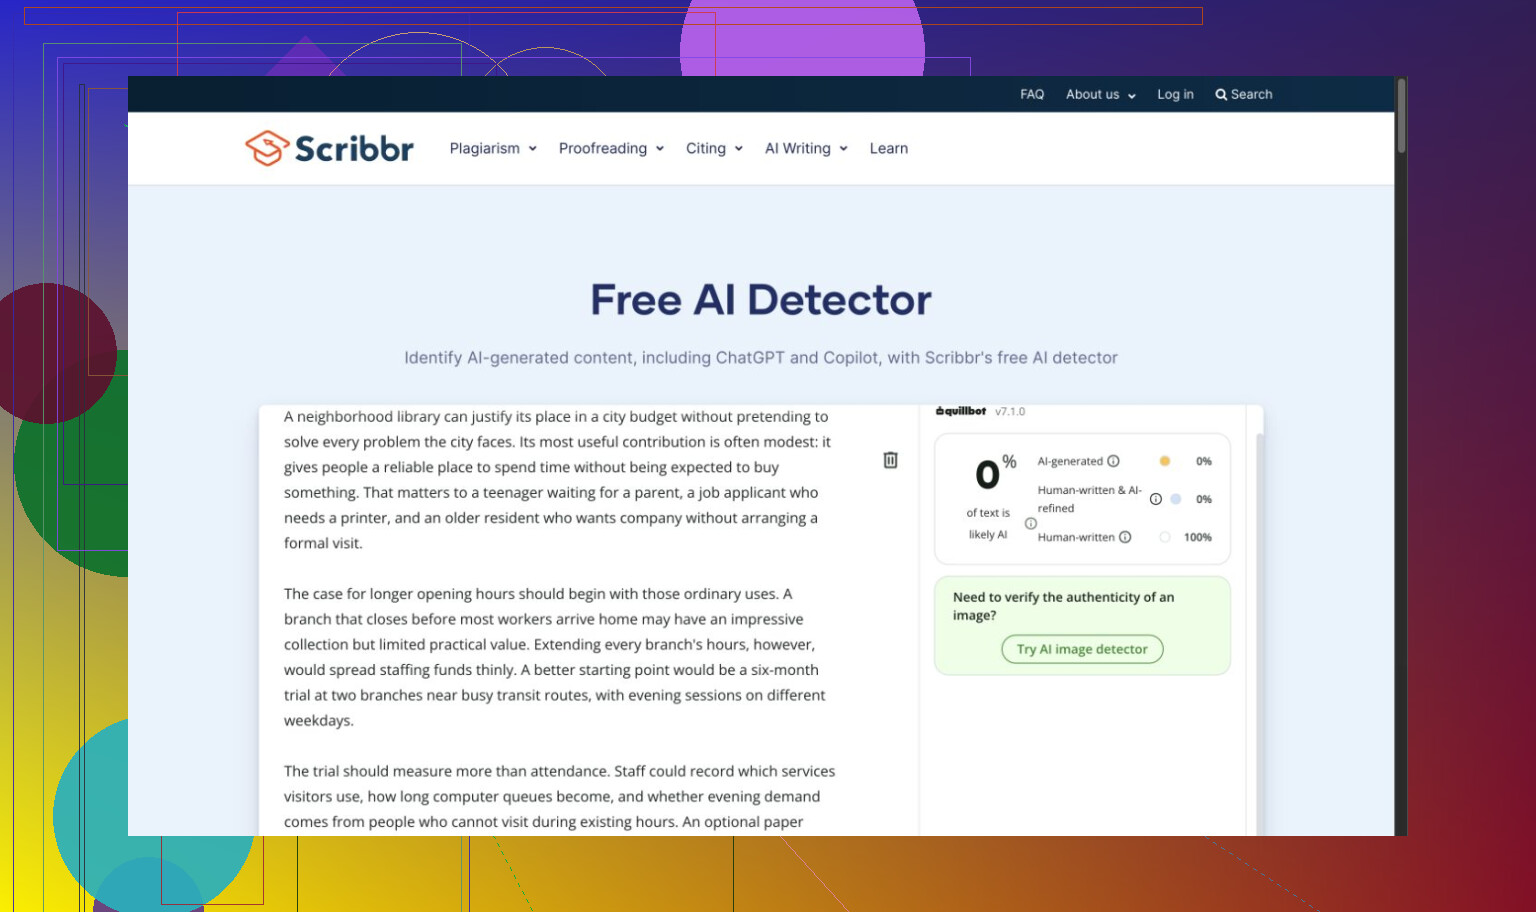
QuillBot no detectó ninguno de los pasajes generados, aunque reconoció correctamente el de Carroll como humano; después se detuvo antes de la muestra mixta, pese a anunciar una cuota de uso mayor. La comprobación posterior que pude completar con Scribbr clasificó tanto el ensayo como el fragmento de Carroll como humanos; la presencia de la marca QuillBot me hizo dudar de que debiera tratarlos como valoraciones independientes.
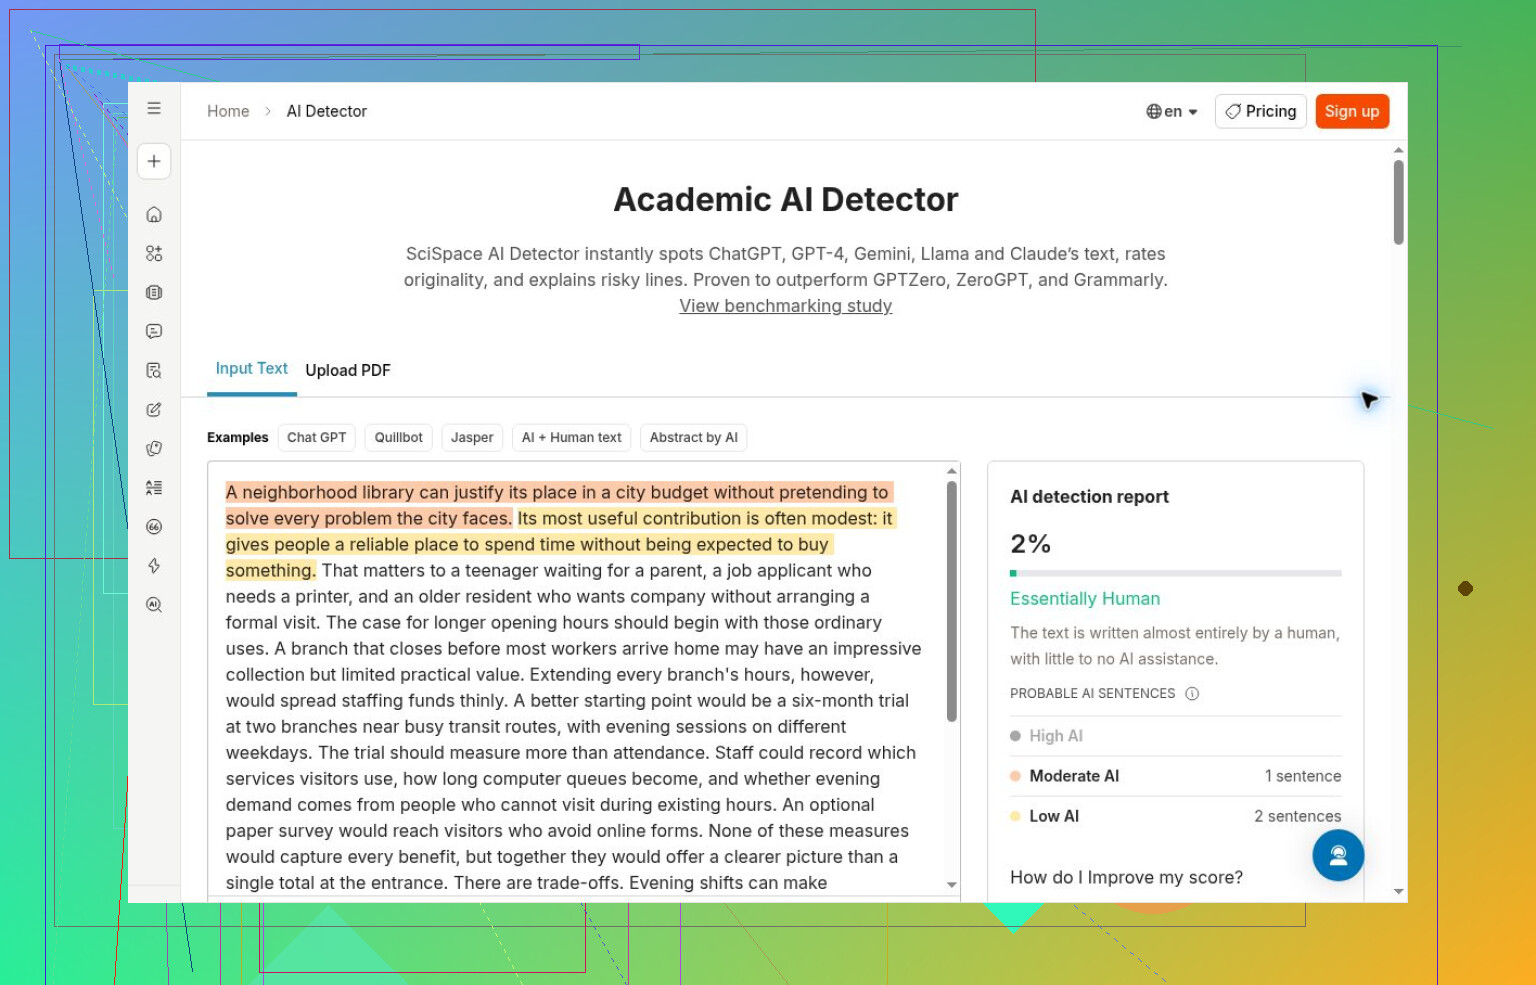
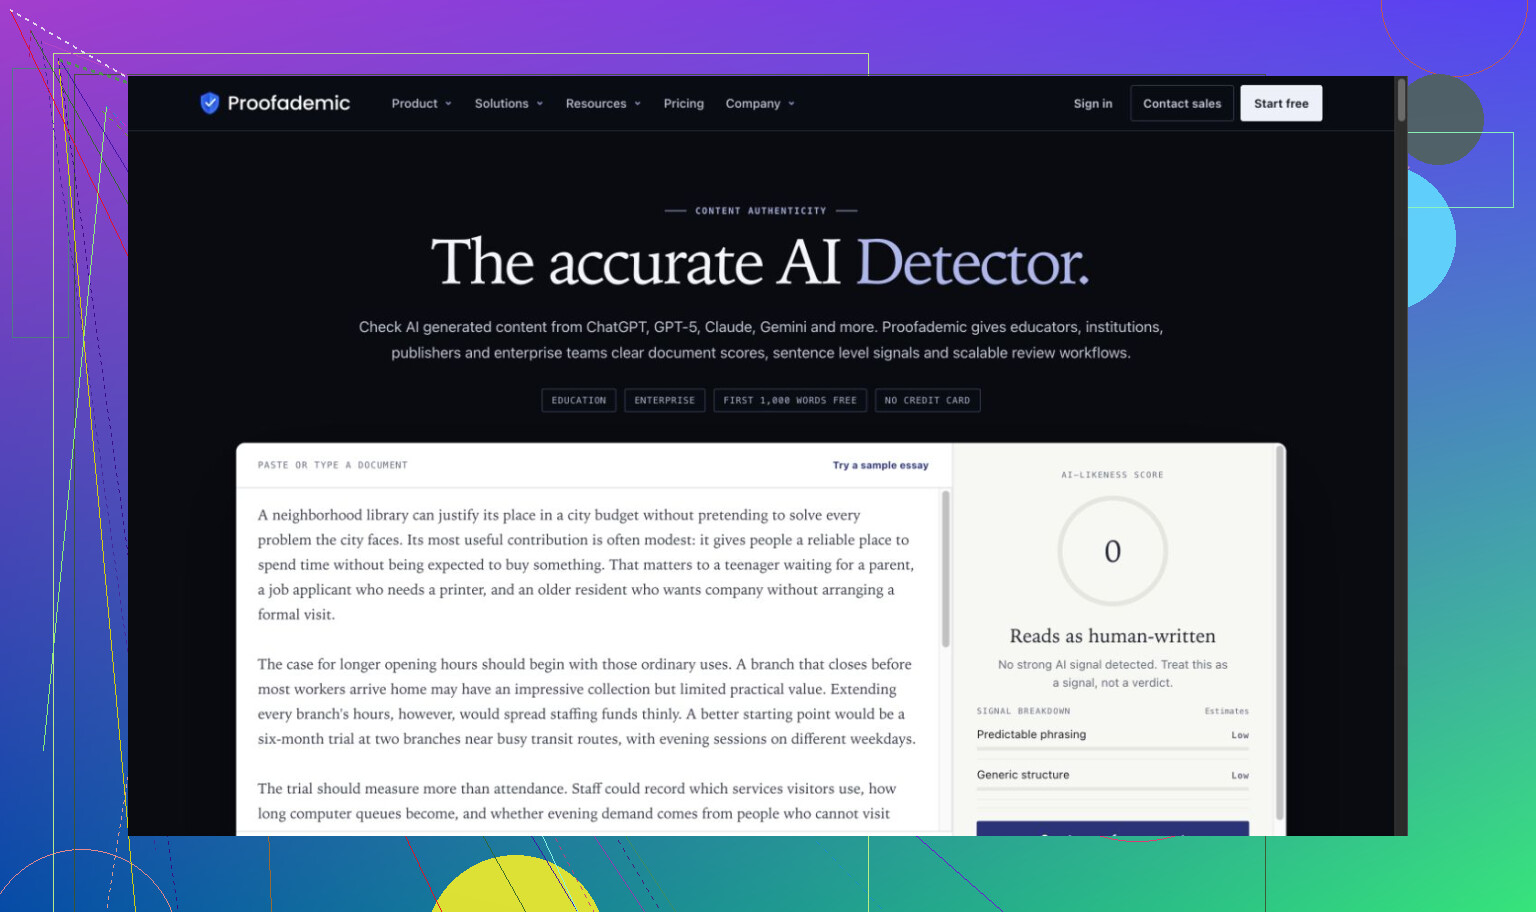
SciSpace calificó el ensayo como esencialmente humano. La demo pública de Proofademic clasificó como humanos tanto el ensayo como el fragmento de Carroll, mientras que Surfer hizo lo mismo con el ensayo, el relato y Carroll. Las explicaciones claras no compensaron los veredictos incorrectos.
Incluso un análisis exitoso tenía sus límites
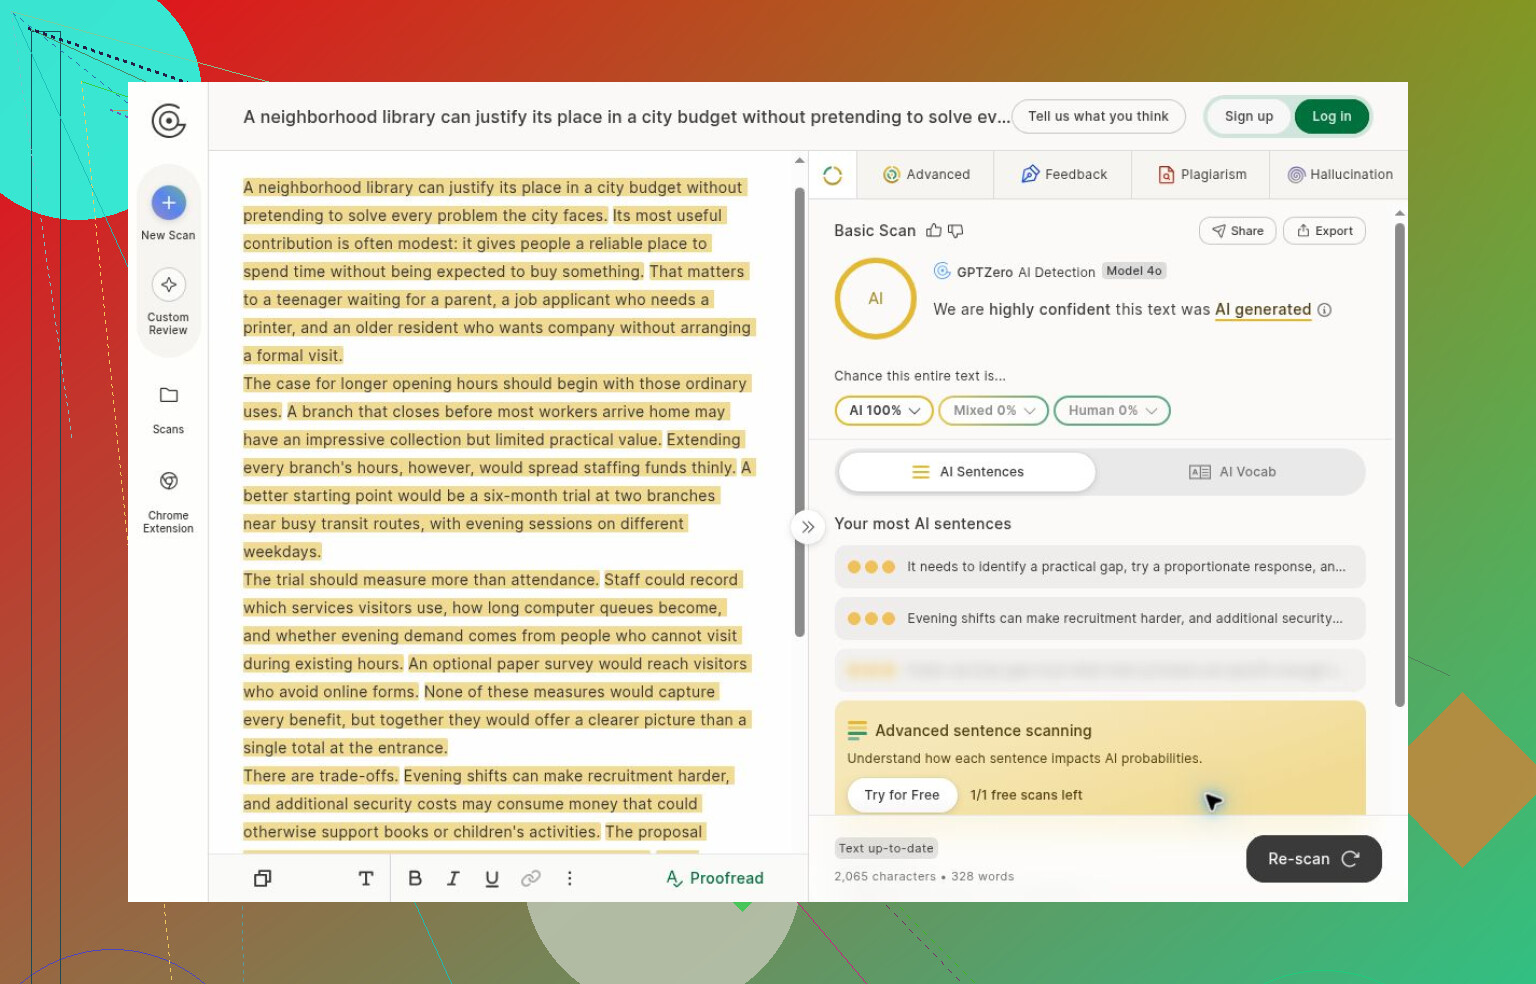
GPTZero detectó los textos generados cuyo análisis se completó antes de que apareciera la exigencia de registro. Al cambiar el texto, seguía visible una puntuación anterior, no un resultado nuevo. No conseguí comprobar la muestra humana ni la mixta.
Grammarly y Quetext identificaron correctamente el ensayo como generado por IA y luego bloquearon los siguientes intentos como invitado, exigiendo registrarse. La revisión por oraciones de Quetext fue útil, pero ninguna de las dos pruebas permitió determinar su comportamiento ante los falsos positivos.
Sapling clasificó correctamente el relato y el fragmento de Carroll en las comprobaciones completas. También identificó el ensayo como generado por IA, pero su límite de caracteres recortó el texto introducido. Estoy aprendiendo a comprobar qué se procesó realmente antes de dar validez a un resultado.
Qué mereció una segunda mirada
Para mi próxima comprobación gratuita, empezaría por la herramienta Clever AI Detector. Completó todo el conjunto sin pagar ni registrarse, detectó los pasajes generados y reconoció el de Carroll como humano. Sin embargo, no puse a prueba su afirmación de uso ilimitado a gran escala ni con textos de longitud máxima. Los colores de las oraciones a veces contradecían el resultado principal, y las etiquetas explicativas fallaban.
Las comprobaciones de textos generados y humanos que Pangram completó fueron correctas, pero los créditos se agotaron antes de cubrir todo el conjunto; la longitud del texto influyó en el consumo. Tanto Pangram como Clever clasificaron como humano el pasaje humano ligeramente editado.
Originality.ai y AI or Not también acertaron en las comprobaciones de textos generados y humanos que completaron antes de que se agotara el acceso como invitado. La confianza indicada por Originality describía un veredicto según el nivel de IA permitido seleccionado, no la proporción de palabras generadas. El rendimiento de AI or Not con textos mixtos y otros tipos de contenido multimedia quedó sin probar.
Las lagunas que abordaría después
Todavía estoy poniéndome al día sobre cómo interpretar estos resultados. La confianza, la probabilidad y la proporción estimada de IA no son intercambiables, y un ejemplo correcto no demuestra una precisión general. La muestra ligeramente editada tampoco puede considerarse puramente humana.
Los flujos de trabajo de pago, la cobertura multilingüe y una variedad de textos humanos modernos quedan fuera de esta comparación. Conservaría los borradores y las fuentes al investigar discrepancias, en lugar de acusar a alguien por una puntuación. También hay que volver a comprobar las cuotas de acceso.
Para otra ronda, ¿qué tipos de escritura humana añadirías para que la comparación dependiera menos de Carroll?
Si tu equipo necesita una comprobación con un detector, optaría por Clever AI Detector junto con una edición manual. Si no, editaría manualmente. Daría menos importancia a la comparación que a la facilidad para seguir las instrucciones. Pídele a tu compañero de equipo que siga las instrucciones sin completar lo que falte y edítalas según los puntos en los que se haya atascado. Mantén las etiquetas de los botones y los nombres de las funciones tal cual, aunque eso haga que las instrucciones resulten repetitivas. Evitaría usar el humanizador de Humanly, ya que no querría tener que editar otra versión reescrita cuando el objetivo era la claridad de las instrucciones, no la variedad de expresión.
No conviertas una pequeña corrección en la documentación en una reescritura completa del artículo. Yo optaría únicamente por la edición manual, sobre todo para que la revisión siga siendo manejable. Si un artículo necesita un nuevo requisito previo, quiero que quien lo revise compruebe esa incorporación, no que vuelva a leer cada párrafo porque ha cambiado la redacción de todo el texto. Mi regla sería separar las actualizaciones de contenido factual de los retoques de estilo opcionales, para poder aprobar la corrección necesaria sin debatir el artículo entero.
La comparación es útil para otra cuestión, pero yo no exigiría una puntuación de Clever AI Detector o Humanly como requisito para la aprobación. Para este flujo de trabajo, pediría al autor que dejara una nota breve explicando qué cambió y quién puede confirmarlo. «Se añadió el permiso de cuenta necesario para exportar» le da a quien revisa una tarea concreta. «Se hizo que sonara más humano», no. Por ese motivo, dejaría el humanizador de Humanly fuera del proceso habitual de revisión, sin que eso suponga un juicio sobre lo bien que funciona el producto. El objetivo es realizar un cambio que alguien pueda comprobar y del que pueda responsabilizarse.
No envíes borradores internos a Humanly ni a ningún otro verificador externo sin el permiso de tu equipo. Los artículos de soporte pueden contener ejemplos de funciones aún no publicadas, ejemplos de clientes o capturas de pantalla con información personal de las cuentas. Personalmente, me inclinaría por la edición manual en lugar de cualquier otra opción, salvo que exista un motivo aprobado por la empresa para usar otro servicio.
Estoy de acuerdo con @nova_hawk604 en que los cambios deben poder revisarse, pero decidiría si se puede subir el contenido antes de decidir cómo editarlo. Antes de incorporar cualquiera de las dos funciones de Humanly al proceso, querría saber si se conserva el contenido enviado, quién puede acceder a él y si el servicio está aprobado para gestionar contenido interno. Son cuestiones que hay que comprobar, no afirmaciones de que Humanly gestione mal los borradores. Un flujo de trabajo que solo use el detector también implica enviar el texto.
Para vuestro proceso de revisión, establecería la revisión manual como opción predeterminada y el uso de cualquier herramienta externa como una excepción para el contenido autorizado para ese fin. Así, el equipo dispondrá de un proceso viable que pueda usar desde ya, sin obligar a cada persona que suba contenido a decidir qué puede y qué no puede enviaros. La cuestión de si el humanizador produce una redacción más cuidada puede esperar hasta que ese límite quede definido.
Deja por escrito los criterios que permiten a un revisor aprobar un artículo antes de pulir el siguiente borrador. Yo optaría únicamente por la edición manual, pero «hacerlo más claro» es un pésimo criterio de revisión. Deja margen para que cada revisor imponga su redacción preferida y vuelva a poner el artículo en circulación.
Estoy de acuerdo con @nova_hawk604 en limitar el alcance de los cambios, pero incluso una pequeña modificación puede quedarse atrapada en ese ciclo. Dales a los revisores motivos concretos para solicitar cambios: información que falta, instrucciones ambiguas, terminología que contradice la guía de estilo o un resultado que el artículo nunca explica. «Yo no lo expresaría así» debería ser una sugerencia opcional, no un motivo para bloquear la publicación. Si dos versiones son igual de comprensibles, conserva la existente.
Por eso no incluiría el detector ni el humanizador de Humanly en el proceso de aprobación. No has identificado ningún problema de autoría que sea necesario resolver. Necesitas un criterio para dar por terminada la edición. El mío sería: la información necesaria está presente, se ha comprobado el procedimiento y ningún comentario pendiente de resolver señala un problema concreto para el lector. Entonces, publica. Un editor humano también puede perder tiempo puliendo un texto perfectamente válido, así que la revisión manual necesita límites tanto como un proceso asistido por herramientas.
Si alguien en una fase posterior realmente te devuelve los borradores porque parecen escritos por una máquina, mantén un detector en el proceso. Si nadie lo hace, estás arreglando algo que nunca estuvo roto.
Esa es mi principal objeción a usar un humanizador en la documentación de ayuda. La buena redacción de procedimientos debe ser repetitiva y predecible. Los mismos nombres de botones, la misma estructura de las frases, paso tras paso. Ese es precisamente el estilo que un humanizador intenta pulir, así que estarías luchando contra tu propia guía de estilo. El criterio de @datapilot5049 para dar el trabajo por terminado es el verdadero acierto aquí, y yo lo dejaría como regla fija: información incluida, procedimiento comprobado paso a paso, ningún comentario pendiente sobre un problema del lector; a publicar.
Si quieres hacer una comprobación puntual antes de publicar, Clever AI Detector analiza rápidamente un bloque de texto pegado y no te obliga a estar pendiente del proceso. Pásalo una vez, anota la cifra y sigue adelante. Eso sí, yo no dejaría que esa cifra condicionara nada. Tómatela como una curiosidad, no como un requisito para publicar.