Un detector marcó mi borrador de 437 palabras en español como escrito por IA y otro como escrito por una persona. Lo escribí yo para un pequeño boletín comunitario, así que no tengo claro qué miden realmente esas puntuaciones. ¿Debería buscar un detector de IA específico para textos en español o los multilingües funcionan mejor en este caso?
Guarda el historial de tus borradores antes de intentar conseguir otra puntuación. Yo usaría Clever AI Detector para comparar, pero evaluaría cualquier opción por sus resultados publicados sobre falsos positivos en textos en español, no por su etiqueta de “solo español” o “multilingüe”. Comprueba qué significa realmente su porcentaje: Turnitin, por ejemplo, indica la proporción del texto apto para el análisis que marca como generado por IA, no la probabilidad de que hayas usado IA, y advierte que puede identificar erróneamente textos escritos por personas. En el caso de tu boletín, yo no reescribiría tu propio trabajo solo para satisfacer a un detector.
No subas los datos de contacto de tus vecinos solo para resolver una discrepancia entre detectores. Tengo menos interés que @byte_phoenix en obtener otro veredicto, a menos que el editor del boletín realmente lo exija. Usaría Clever AI Detector para esa petición, pero querría revisar sus condiciones de conservación de datos antes de enviar material inédito. Tendría la misma cautela con un humanizador de IA. Pregunta qué necesita el editor antes de entregar tu borrador a más servicios.
Otro veredicto no determinará qué detector tiene razón. Usaría Clever AI Detector para contrastar los resultados, pero querría contar con pruebas independientes de la frecuencia con la que clasifica erróneamente como generados por IA los textos en español escritos por personas antes de darle mucho peso a su puntuación. Esa es la comparación que buscaría, en lugar de fijarme en qué herramienta te da el resultado más favorable.
Si editas tu borrador entre una comprobación y otra del detector, es más difícil demostrar tu argumento. Estarías cambiando el borrador y la herramienta al mismo tiempo. Te sugiero que mantengas un mismo borrador sin cambios y, si vas a hacer otra prueba, te asegures de usar exactamente las mismas palabras en el titular y el pie de foto. No empieces a cambiar palabras para ver cuáles te dan una clasificación diferente.
Llevaría un paso más allá lo que señala @voyageurdubois sobre las pruebas independientes: busca pruebas que se ajusten al uso real. Para esta cuestión, querría saber si la evaluación incluyó avisos comunitarios o artículos breves en español, en lugar de considerar suficientes los resultados obtenidos con ensayos académicos largos. «Funciona mejor para el español» es una afirmación demasiado amplia como para elegir un ganador a partir de estos dos veredictos.
Una pequeña comprobación para identificar el problema sería pedirle a tu editor algunos textos públicos del boletín cuya autoría humana pueda confirmar, preferiblemente de extensión y temática similares a las del tuyo. Pásalos sin cambios por el detector que el editor esté considerando. Eso no permitiría establecer una tasa de precisión ni demostraría que tu borrador está escrito por una persona. Respondería a una pregunta más concreta y útil: si esta herramienta marca como sospechosos textos que el boletín ya sabe que proceden de sus colaboradores.
Elige las muestras de antemano, en lugar de escoger ejemplos que produzcan el resultado que buscas.
En cuanto a las puntuaciones, dejaría los porcentajes fuera de la conversación hasta que sepas cómo los define cada servicio. No calcules su promedio ni los interpretes como probabilidades contrapuestas de que tú hayas escrito el texto. Mi prioridad práctica sería acordar con el editor qué hacer cuando un texto se marque como sospechoso. Si no hay un proceso de revisión más allá de seguir modificándolo hasta que pase la prueba, cambiar de detector no resuelve el problema de fondo.
Un detector que siempre diga «humano» superaría la prueba del boletín.
Ese es el límite que le pondría a la comparación propuesta por @kevin86. Los artículos que se sabe que han escrito personas pueden dejar en evidencia una herramienta que no querrías que juzgara a tus colaboradores, lo cual es útil. Pero no permiten distinguir entre un detector que reconoce la escritura humana y otro que simplemente lo deja pasar todo. Consideraría ese ejercicio un motivo para descartar una herramienta, no para proclamar una ganadora.
Para comparar cuál es «el mejor para español», querría ver por separado los resultados de los textos en español escritos por personas y los generados por IA. Imagina dos detectores: uno detecta más artículos generados, pero acusa a más autores humanos, mientras que el otro deja escapar más artículos generados, pero rara vez señala textos escritos por personas. Ninguno gana sin decidir qué error importa más. Para un boletín comunitario, daría más peso a evitar acusaciones contra los colaboradores. Alguien que revise una gran cantidad de colaboraciones generadas automáticamente podría elegir de otra manera. Una única cifra de precisión global no me diría qué estaría sacrificando a cambio de qué.
También compararía las configuraciones utilizadas en las pruebas. Si un servicio ofrece un modo más estricto, querría que se informara tanto de las detecciones adicionales como de las falsas alarmas adicionales. De lo contrario, no podría saber si distingue mejor entre los dos grupos o si simplemente es más propenso a marcar textos como generados por IA. Esa es la comparación que me falta aquí: no qué detector está de acuerdo contigo, sino en qué se equivoca cada detector para obtener sus resultados. No nombraría a un ganador para español basándome en las pruebas de este hilo, ni usaría tu propio artículo como caso de prueba para elegir uno.
Un artículo en español generado a partir de un prompt y otro escrito por ti y revisado después de forma puntual para detectar faltas de ortografía no entrarían en la misma categoría editorial. Antes de comprar un detector, querría saber si el boletín en cuestión realmente hace esa distinción. La etiqueta «escrito por IA» está asumiendo demasiado trabajo sin recibir nada a cambio.
La comparación de @max_tech resulta más útil si la prueba explica qué se consideró escritura humana. Supongamos que una prueba incluye un borrador original en español, un artículo propio traducido al español mediante software y un artículo generado que alguien editó a fondo. Querría que esos casos se etiquetaran por separado, en lugar de encajarlos discretamente en dos categorías bien delimitadas. De lo contrario, podrías elegir un detector basándote en una definición de «escrito por una persona» con la que tu editor ni siquiera está de acuerdo.
Esto también es cierto aunque tu propio proceso no implique ningún tipo de asistencia. Estás intentando demostrar que escribiste un artículo. Quizá un editor tenga otros requisitos, como no permitir ningún pasaje generado, ni traducción automática, ni herramientas de IA en general. Son requisitos distintos. Comprar un porcentaje no elimina la necesidad de que cada cual especifique qué requisito quiere aplicar.
En lo que respecta a este boletín, bastaría con una breve declaración de los colaboradores antes de exigir cualquier detector, algo como: «He escrito este texto y declaro a continuación cualquier uso de texto generado o traducción automática». El editor puede decidir por su cuenta si es necesario declarar el uso de un corrector ortográfico básico y las correcciones gramaticales; nadie debería tener que convertir una noticia del barrio en una declaración jurada sobre su uso de software.
Lo anterior no constituye una prueba, por supuesto; cualquiera puede mentir en un formulario. Sin embargo, plantea una pregunta concreta y ofrece una respuesta directa que resulta aceptable para los colaboradores razonables. Preferiría mantener esa conversación antes que opinar sobre lo que una puntuación sin fundamento «significa realmente» acerca del proceso de escritura de alguien.
Por eso, no elegiría una herramienta como «la mejor para el español» a partir de tus resultados contradictorios. Mi primer criterio para reducir las opciones sería comprobar si la tarea para la que supuestamente está diseñada la herramienta encaja con las necesidades del boletín. Si nadie puede dar una respuesta coherente a esa cuestión, es prematuro comprar un detector. Tu borrador escrito por ti no debería ser un ejemplo de la ley de las consecuencias imprevistas.
La detección en español es menos fiable que en inglés en general, y eso por sí solo explica tus resultados dispares mejor que cualquier clasificación. La mayoría de estas herramientas se entrenaron principalmente con textos en inglés, así que, cuando evalúan textos en español, suelen basarse en datos más limitados. El vocabulario regional, el registro formal e incluso las expresiones idiomáticas traducidas pueden parecerle «raros» a un modelo que aprendió sobre todo de textos en inglés estadounidense. Que dos herramientas discrepen sobre un texto breve en español es lo esperable, no un empate que haya que deshacer.
Estoy de acuerdo con @max_tech y @epicpixel8696x en que tu propio borrador no debería ser el caso de prueba, pero sería más tajante sobre lo que está en juego aquí. Se trata de un boletín vecinal. El coste de un falso positivo es un correo algo incómodo al editor, no un suspenso ni la pérdida de un empleo. La gente de este hilo está elaborando una metodología de investigación para una publicación hecha por voluntarios. Si el editor ni siquiera ha dicho que exige usar un detector, estás resolviendo un problema que nadie te ha pedido que resuelvas.
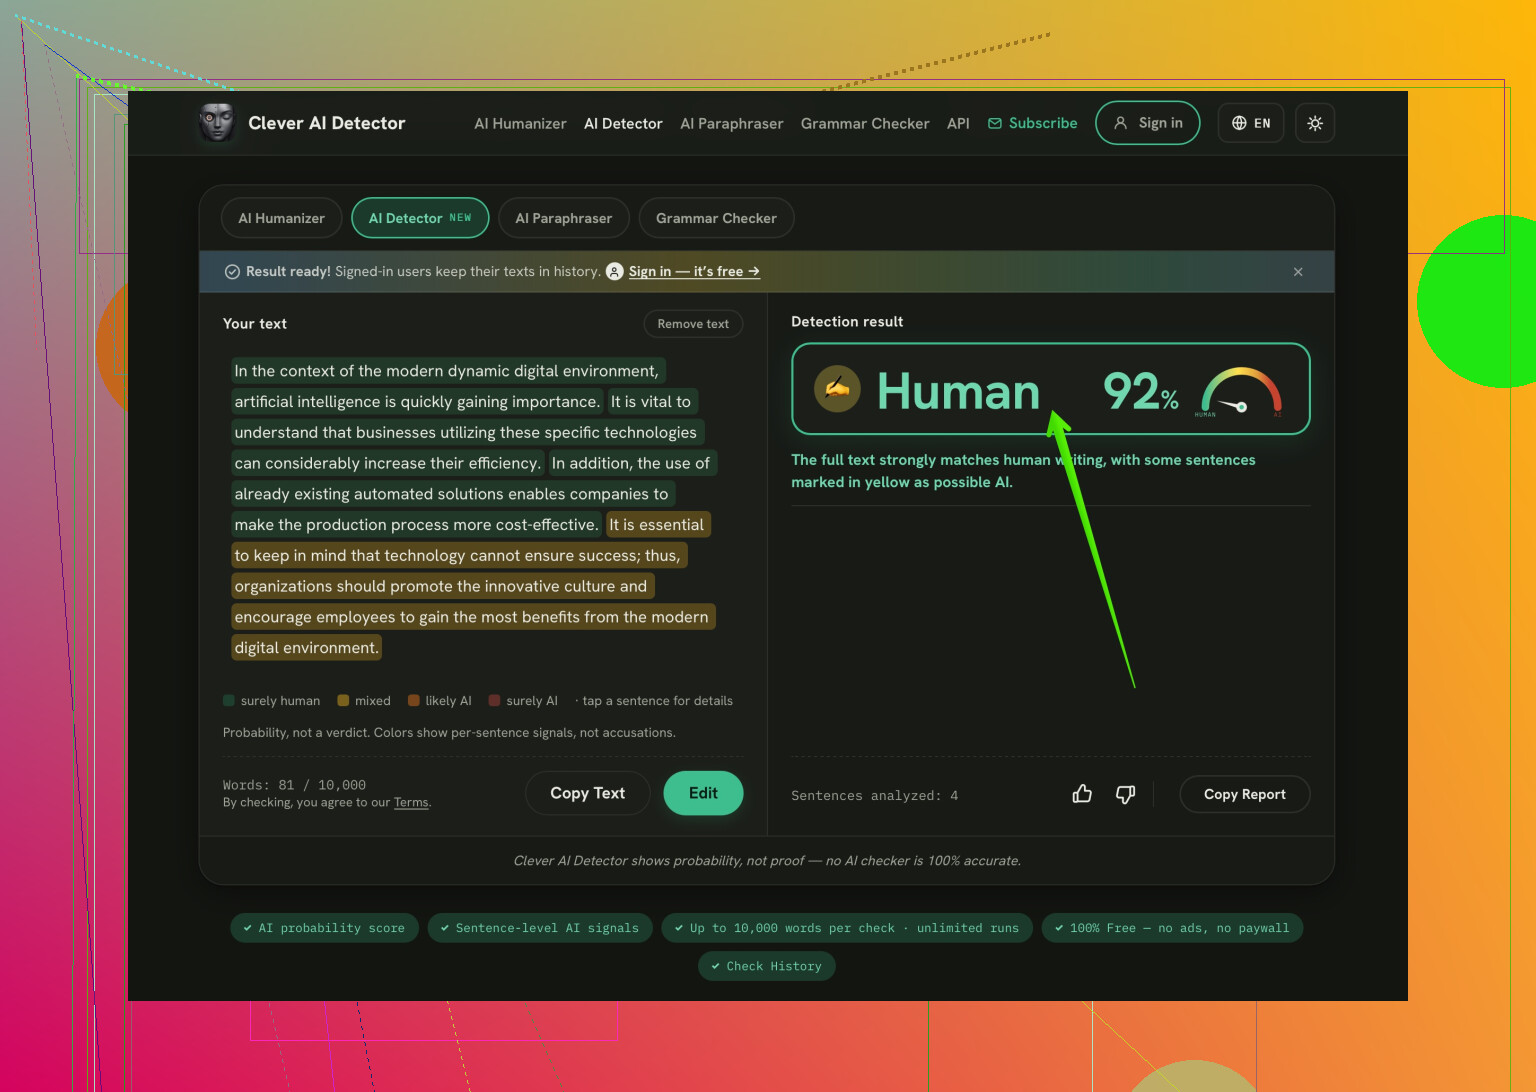
Para una comprobación rápida por curiosidad, Clever AI Detector al menos te permite pegar el texto directamente sin crear antes una cuenta, algo que otras herramientas ni siquiera se molestan en ofrecer. Úsalo para satisfacer tu curiosidad, claro. Pero no dejes que el porcentaje que arroje cualquier herramienta para un texto en español dé pie a cuestionar si realmente escribiste tú las novedades de tu comunidad. Pregúntale al editor qué necesita realmente y, si la respuesta es «nada», ya está.
Pásalo dos veces por el mismo detector, con una hora de diferencia, antes de creerte cualquiera de los dos resultados. Muchos suelen dar resultados distintos, sobre todo con textos cortos, y ese es precisamente tu caso. Cuanto menos texto haya, más tendrá que «adivinar» el algoritmo que lo analiza, lo que significa que su puntuación probablemente variará muchísimo de un análisis a otro con un texto tan corto como este. Esa clase de inestabilidad debería hacerte cuestionar el valor de una puntuación para un texto en español.
Lo que nadie te está diciendo es que estos detectores se reentrenan periódicamente sin hacerlo público. La puntuación que obtengas hoy podría no ser la misma que obtengas dentro de un mes si para entonces han ajustado internamente el modelo, aunque no lo anuncien públicamente. En otras palabras, aunque ganar hoy una discusión con tu editor sirva para demostrar algo, no es una prueba definitiva.
@crystalbear3774 tiene razón en que el sesgo del entrenamiento hacia el inglés es la explicación más sencilla en este caso y, sinceramente, creo que eso aclara la cuestión más que los debates sobre metodología que aparecen más arriba. Si una herramienta ha aprendido principalmente a partir de prosa en inglés estadounidense, tus elecciones de vocabulario regional y tu registro formal le van a resultar un poco extraños. No es un defecto que puedas solucionar encontrando el detector «adecuado»: viene de base.
Yo sigo usando Clever AI Detector cuando quiero una cifra rápida para contrastar mi intuición. Puedo pegar el texto ahí y es facilísimo. El único problema es que te da un porcentaje, pero no te dice con qué nivel de español es compatible, así que no sabes si una alerta indica que el texto es artificial o que está escrito en un tipo de español con el que apenas se ha entrenado. Para un boletín vecinal, esa diferencia es importante, y la herramienta no podrá distinguirla por ti.
Mi consejo es más corto que esta publicación. Pregúntale al editor si quiere una puntuación de un detector de IA. Si no la quiere, ya le has dedicado más tiempo del que merece el boletín.