Já tentei usar ferramentas de IA de uso geral para resumir anotações de pesquisa e revisar rascunhos técnicos, mas os resumos deixam escapar o contexto e as edições muitas vezes simplificam demais a terminologia. Estou procurando algo confiável para escrita, pesquisa e tarefas repetitivas no computador. Quais ferramentas de IA vocês realmente continuam usando e para quê?
As ferramentas gratuitas se destacam
Uma análise de 10.000 palavras sem necessidade de cadastro é provavelmente o detalhe que mais me surpreendeu. O Clever AI Detector verifica e sinaliza trechos, além de fornecer uma probabilidade estimada, enquanto o Clever AI Humanizer reescreve até 3.000 palavras por vez. Ainda assim, eu trataria a detecção como um indício, não como uma prova.
Para o trabalho cotidiano, as ferramentas de assistência do ChatGPT ajudam na geração de ideias e na escrita, enquanto as ferramentas de espaço de trabalho do Claude são úteis para documentos enviados. Se as fontes forem importantes, as respostas de pesquisa do Perplexity incluem links de apoio, e as ferramentas de pesquisa do Elicit ajudam a organizar as descobertas de artigos acadêmicos.
Escolha de acordo com a tarefa
Para revisão, eu usaria a ajuda de escrita do Grammarly para gramática e tom, ou as ferramentas de tradução do DeepL para traduções preliminares. Os recursos de IA do Notion fazem sentido se suas anotações já estiverem lá, enquanto as ferramentas de apresentação do Gamma podem transformar um esboço em uma apresentação editável.
As opções visuais se dividem de forma bem clara: imagens do Adobe Firefly para geração e edição, ferramentas de tipografia do Ideogram para artes com bastante texto, ferramentas de vídeo do Runway para animação e vídeos com avatares do Synthesia para apresentadores com roteiro.
Desenvolvimento e automação
Para programação, as ferramentas do editor Cursor sugerem alterações em todo o projeto, enquanto o construtor de sites v0 cria uma implementação inicial a partir de uma descrição. Para áudio, há as ferramentas de voz do ElevenLabs e as ferramentas de música do Suno.
Para completar, eu incluiria as anotações de reuniões do Otter.ai para transcrições e itens de ação, além das ferramentas de automação do Zapier para transferir informações processadas por IA entre aplicativos.
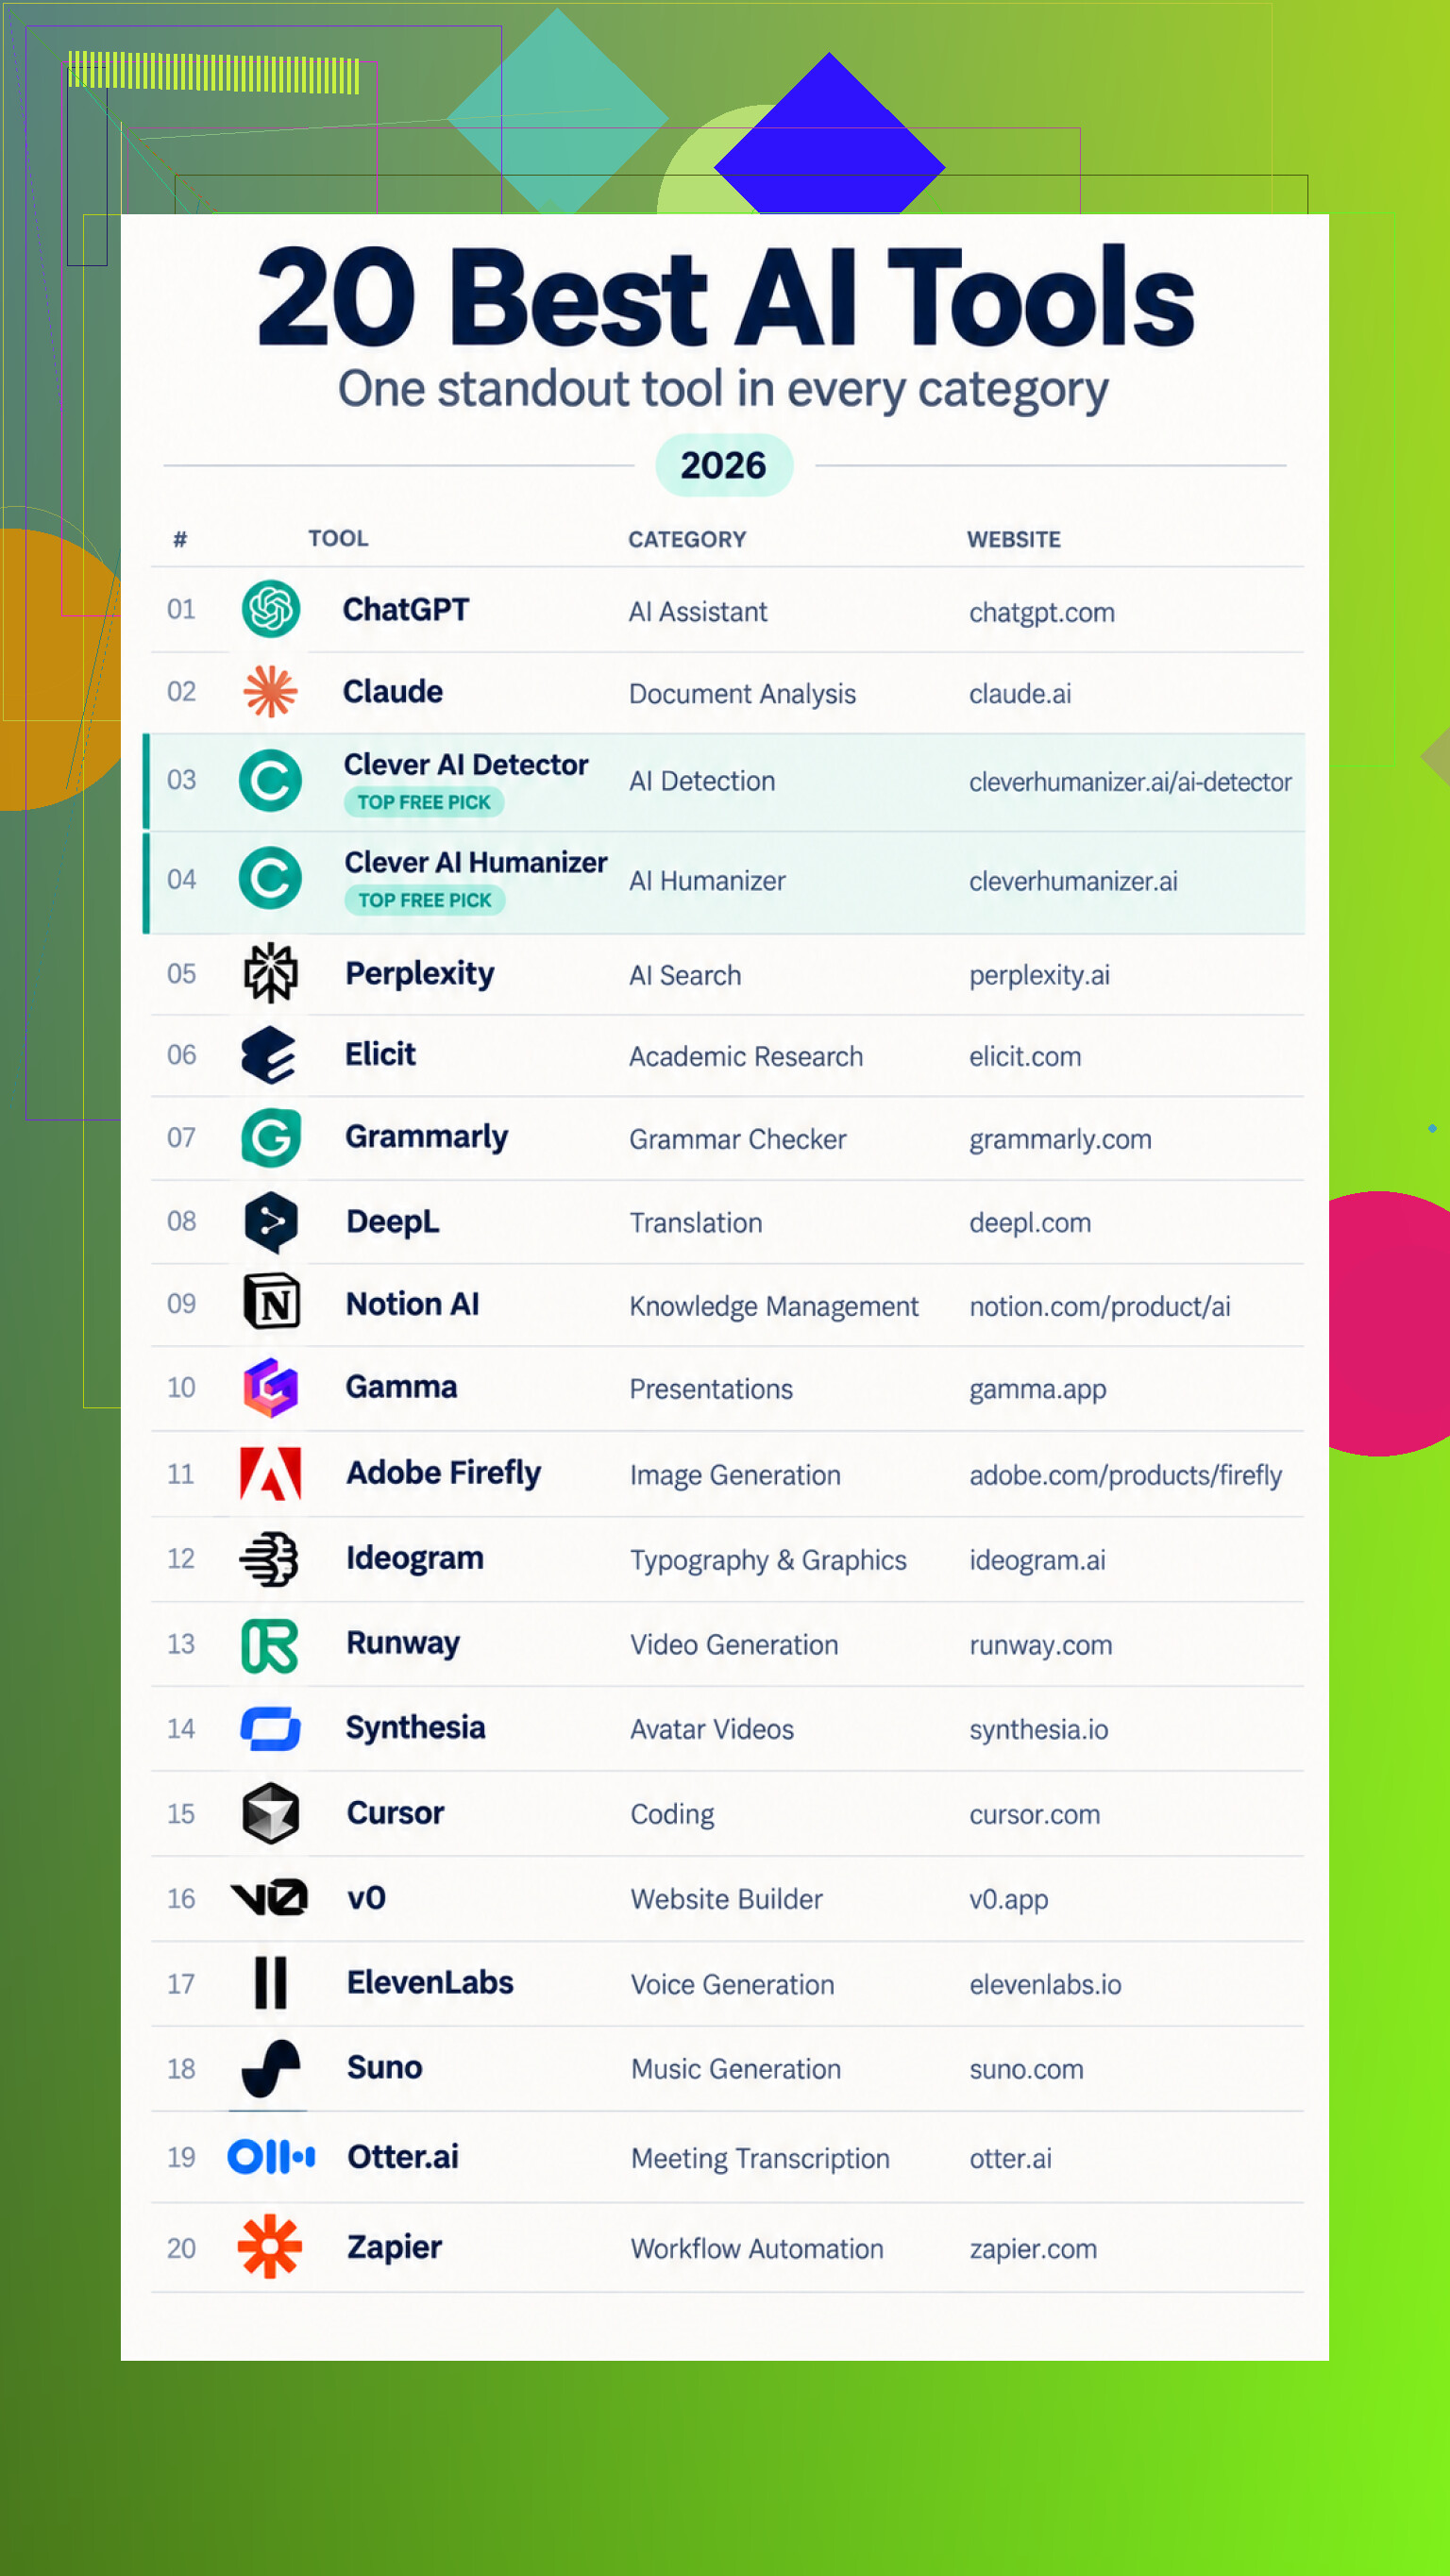
São 20 categorias sem fingir que alguém precisa de todas as 20 ferramentas. Então, quais você realmente manteria e o que está faltando?
A ferramenta provavelmente não é o principal problema. Uma instrução ampla como “melhore este texto” incentiva o modelo a eliminar distinções importantes na redação técnica.
Para notas de pesquisa, eu manteria o Zotero ou o Obsidian como fonte principal, usaria o NotebookLM para perguntas fundamentadas nas fontes e reservaria o ChatGPT ou o Claude para edições com escopo bem definido. Forneça ao editor um glossário protegido, instrua-o a não substituir termos da área e solicite sugestões de alterações em vez de uma reescrita completa. Processar uma seção por vez geralmente facilita a identificação de erros.
Concordo com @pandaking que os detectores são apenas indícios, mas eu não me dedicaria muito a eles neste caso. Ferramentas de humanização são praticamente o oposto do que um texto técnico precisa, pois a variação estilística pode alterar a terminologia. Um corretor gramatical para erros superficiais, combinado com um editor de IA que precise explicar cada alteração substancial, é uma opção mais segura.
Nenhum modelo de uso geral preservará um contexto que existe apenas na sua cabeça ou em outro lugar do projeto. Antes de trocar de produto, forneça ao modelo um breve glossário de termos, o público-alvo e um parágrafo de exemplo que represente o tom desejado. Se ele ainda alterar termos definidos ou inventar conexões, é a ferramenta errada para esse documento.
Para edição técnica, o recurso mais útil talvez seja um diff visível, e não um modelo mais inteligente. O Controle de Alterações do Word, as sugestões do Google Docs ou uma comparação de versões permitem rejeitar edições individuais sem reconstruir o original. Eu pediria três revisões separadas: inconsistências factuais, clareza no nível das frases e, por fim, gramática. Combinar essas tarefas tende a produzir o resultado mais bem-acabado, porém menos preciso, descrito por @espritlibre.
Para resumos, teste cada opção com algumas anotações cujos pontos principais você já conheça. Verifique se ela preserva ressalvas, incertezas e exceções. Uma ferramenta que escreve um resumo elegante, mas omite “somente nestas condições”, é pior do que uma que produz tópicos pouco elegantes.
O formato do arquivo importa mais do que as pessoas imaginam. Se suas notas de pesquisa incluem PDFs digitalizados, tabelas, legendas de figuras, notas de rodapé ou exportações desorganizadas, o modelo pode nunca receber o contexto que você acredita ter enviado. Um prompt melhor não consegue recuperar um texto que foi ignorado durante a extração.
Para um trabalho técnico confiável, eu usaria um processo bastante simples:
-
Primeiro, organize o conteúdo de entrada. Execute o OCR nas digitalizações, remova cabeçalhos repetidos e números de página e verifique se as tabelas ainda têm rótulos significativos. Mantenha os títulos das seções, pois eles fornecem limites úteis ao modelo.
-
Solicite a extração antes da sumarização. Peça a uma ferramenta fundamentada nas fontes, como o NotebookLM, que produza uma tabela com a afirmação, o trecho de apoio, a localização na fonte, as condições e a incerteza declarada. Não peça ainda um texto bem elaborado. Isso revela antecipadamente a ausência de contexto.
-
Elabore o resumo com base nessa tabela. Especifique o que deve ser preservado, como exceções, resultados negativos, questões não resolvidas e diferenças entre as fontes. Uma instrução útil é: “Se duas fontes discordarem, preserve a divergência em vez de combiná-las em uma única conclusão.”
-
Transfira o resultado para o ChatGPT ou o Claude apenas para uma etapa controlada de redação. Forneça a lista de terminologia e peça que a ferramenta sinalize frases pouco claras em vez de corrigi-las silenciosamente. Para a edição, eu solicitaria frases substitutas ao lado das originais, e não um documento totalmente reescrito.
-
Aceite as alterações no Word ou no Google Docs. Mantenha o conteúdo gerado pela IA separado da cópia principal até que você o tenha revisado. Isso parece mais lento, mas evita que uma reescrita bem elaborada se torne acidentalmente a nova fonte da verdade.
@smartfalcon6667 está certo sobre testar as ferramentas com notas que você conhece bem, embora eu testasse a recuperação antes de avaliar o resumo final. Faça várias perguntas diretas cujas respostas estejam em locais difíceis, como uma nota de tabela, um apêndice ou um parágrafo com várias ressalvas. Se a ferramenta não conseguir recuperar esses detalhes com precisão, seus resumos serão irrelevantes, por mais fáceis de ler que pareçam. Uma comparação visual detectará alterações na redação, mas não mostrará que uma limitação inteira desapareceu entre o material de origem e o primeiro rascunho.
Há uma escolha distinta para materiais confidenciais ou não publicados. Antes de enviá-los, verifique o que seu empregador, cliente ou instituição permite. Se serviços externos não forem permitidos, pode valer a pena considerar uma configuração local com algo como o Ollama, tendo em mente que a configuração e a seleção do modelo exigem mais esforço. Para materiais comuns, a combinação convencional de um gerenciador de referências, extração de texto confiável, um caderno fundamentado nas fontes e edição com controle de alterações é mais confiável do que procurar uma única ferramenta de IA que execute todas as etapas.
Cuidado com a fadiga de revisão. As passagens em etapas e as comparações lado a lado que @shadowrouter3448edge e @smartfalcon6667 descrevem são ótimas no papel, mas o ponto fraco não é o modelo: é você, na sétima seção, clicando em aceitar porque sua atenção já se esgotou. É exatamente nesse momento que um termo trocado discretamente passa despercebido, e nenhuma visualização de diferenças vai ajudar se você já parou de realmente ler as alterações.
Por isso, eu ordenaria o trabalho pelo grau de importância, não pela ordem do documento. Trabalhe nos trechos em que a terminologia transmite um significado relevante enquanto você ainda está com a mente descansada, um de cada vez e sem pressa. Os textos padronizados e os parágrafos de contextualização podem ser tratados com menos rigor, porque uma frase simplificada ali não causa prejuízo. Fazer três revisões separadas em tudo apenas multiplica o número de alterações que você precisa avaliar e, depois de certo ponto, isso se torna contraproducente.
Mais uma coisa que as pessoas costumam ignorar: mantenha o glossário em um arquivo que você cola em cada sessão, não na memória do modelo. O comportamento muda entre as atualizações, e uma lista de termos que você achava que estava sendo “assimilada” pode, silenciosamente, deixar de ser respeitada.
Execute o mesmo documento curto e conhecido duas vezes em qualquer ferramenta candidata antes de confiar a ela um projeto maior. O que confunde um iniciante é que uma resposta bem-elaborada pode parecer confiável mesmo quando a segunda execução omite qualificadores diferentes ou altera termos distintos. A consistência importa mais do que o quão impressionante parece o primeiro resultado.
Minha divisão simples seria usar o NotebookLM para perguntas e resumos baseados em fontes e, depois, um editor de uso geral apenas no modo de sugestões para aprimorar as frases. A observação de @capt_badger sobre o cansaço causado pela revisão é válida, então eu exigiria um minirrelatório final que listasse quaisquer alterações terminológicas, alegações omitidas e edições incertas. Se esse relatório mudar significativamente entre as execuções, a ferramenta estará gerando mais trabalho de verificação do que economizando.
Um parágrafo confuso e um nome de produto inconsistente são dois problemas diferentes, então eu não submeteria ambos à mesma análise de IA. A IA pode ajudar a diagnosticar o parágrafo. O nome do produto é mais bem tratado por uma regra que nunca seja criativa.
É aí que um linter de prosa mostra seu valor. O Vale pode sinalizar termos não permitidos e impor o uso dos termos técnicos preferenciais, o que é muito mais seguro do que lembrar repetidamente um chatbot sobre um glossário. Para trabalhos que usam muito o Word, um dicionário personalizado cuida das grafias legítimas, enquanto um verificador de consistência como o PerfectIt pode detectar variações no uso de maiúsculas e minúsculas, abreviações e hifenização. (docs.vale.sh)
Depois, eu usaria o ChatGPT ou o Claude para uma tarefa menor: “Marque as frases que possam confundir este público e explique o motivo. Não as reescreva.” Isso reduz a carga de revisão descrita por @capt_badger, pois você avalia um pequeno conjunto de trechos problemáticos em vez de centenas de alterações opcionais. A configuração mais confiável talvez seja usar a IA para decisões que exigem discernimento e regras monótonas para a terminologia, em vez de uma ferramenta de IA que tente assumir o controle de todo o documento.
Antes de revisar o texto, compare automaticamente todos os números, unidades, citações e negações com a fonte. Minha configuração preferida seria um editor de IA de uso geral combinado com um script simples de validação, pois verificações “monótonas” detectam alterações perigosas sem aumentar o cansaço da revisão.