He probado herramientas de IA de uso general para resumir notas de investigación y pulir borradores técnicos, pero los resúmenes pierden el contexto y las ediciones suelen simplificar demasiado la terminología. Busco algo fiable para la escritura, la investigación y las tareas repetitivas de escritorio. ¿Qué herramientas de IA sigues usando realmente y para qué?
Las herramientas gratuitas destacan
Un análisis de detección de 10.000 palabras sin registro es probablemente el detalle que más me sorprendió. El detector de IA de Clever señala fragmentos y ofrece una probabilidad estimada, mientras que el humanizador de IA de Clever reescribe hasta 3.000 palabras por análisis. Aun así, consideraría la detección un indicio, no una prueba.
Para el trabajo diario, las herramientas del asistente ChatGPT sirven para generar ideas y redactar, mientras que las herramientas del espacio de trabajo de Claude resultan útiles para los documentos subidos. Si las fuentes son importantes, las respuestas de búsqueda de Perplexity incluyen enlaces de respaldo, y las herramientas de investigación de Elicit ayudan a organizar los hallazgos de los artículos.
Elige según la tarea
Para revisar textos, usaría la asistencia de escritura de Grammarly para la gramática y el tono, o las herramientas de traducción de DeepL para obtener una primera versión. Las funciones de IA de Notion tienen sentido si tus notas ya están allí, mientras que las herramientas de presentaciones de Gamma pueden convertir un esquema en una presentación editable.
Las opciones visuales se dividen de forma bastante clara: las imágenes de Adobe Firefly para generar y editar, las herramientas tipográficas de Ideogram para gráficos con mucho texto, las herramientas de vídeo de Runway para contenido en movimiento y los vídeos con avatares de Synthesia para presentadores con guion.
Desarrollo y automatización
Para programar, las herramientas del editor Cursor sugieren cambios para todo el proyecto, mientras que el creador web v0 genera una implementación inicial a partir de una descripción. El audio queda cubierto por las herramientas de voz de ElevenLabs y las herramientas musicales de Suno.
Completaría la selección con las notas de reuniones de Otter.ai para obtener transcripciones y tareas pendientes, además de las herramientas de automatización de Zapier para transferir información procesada por IA entre aplicaciones.
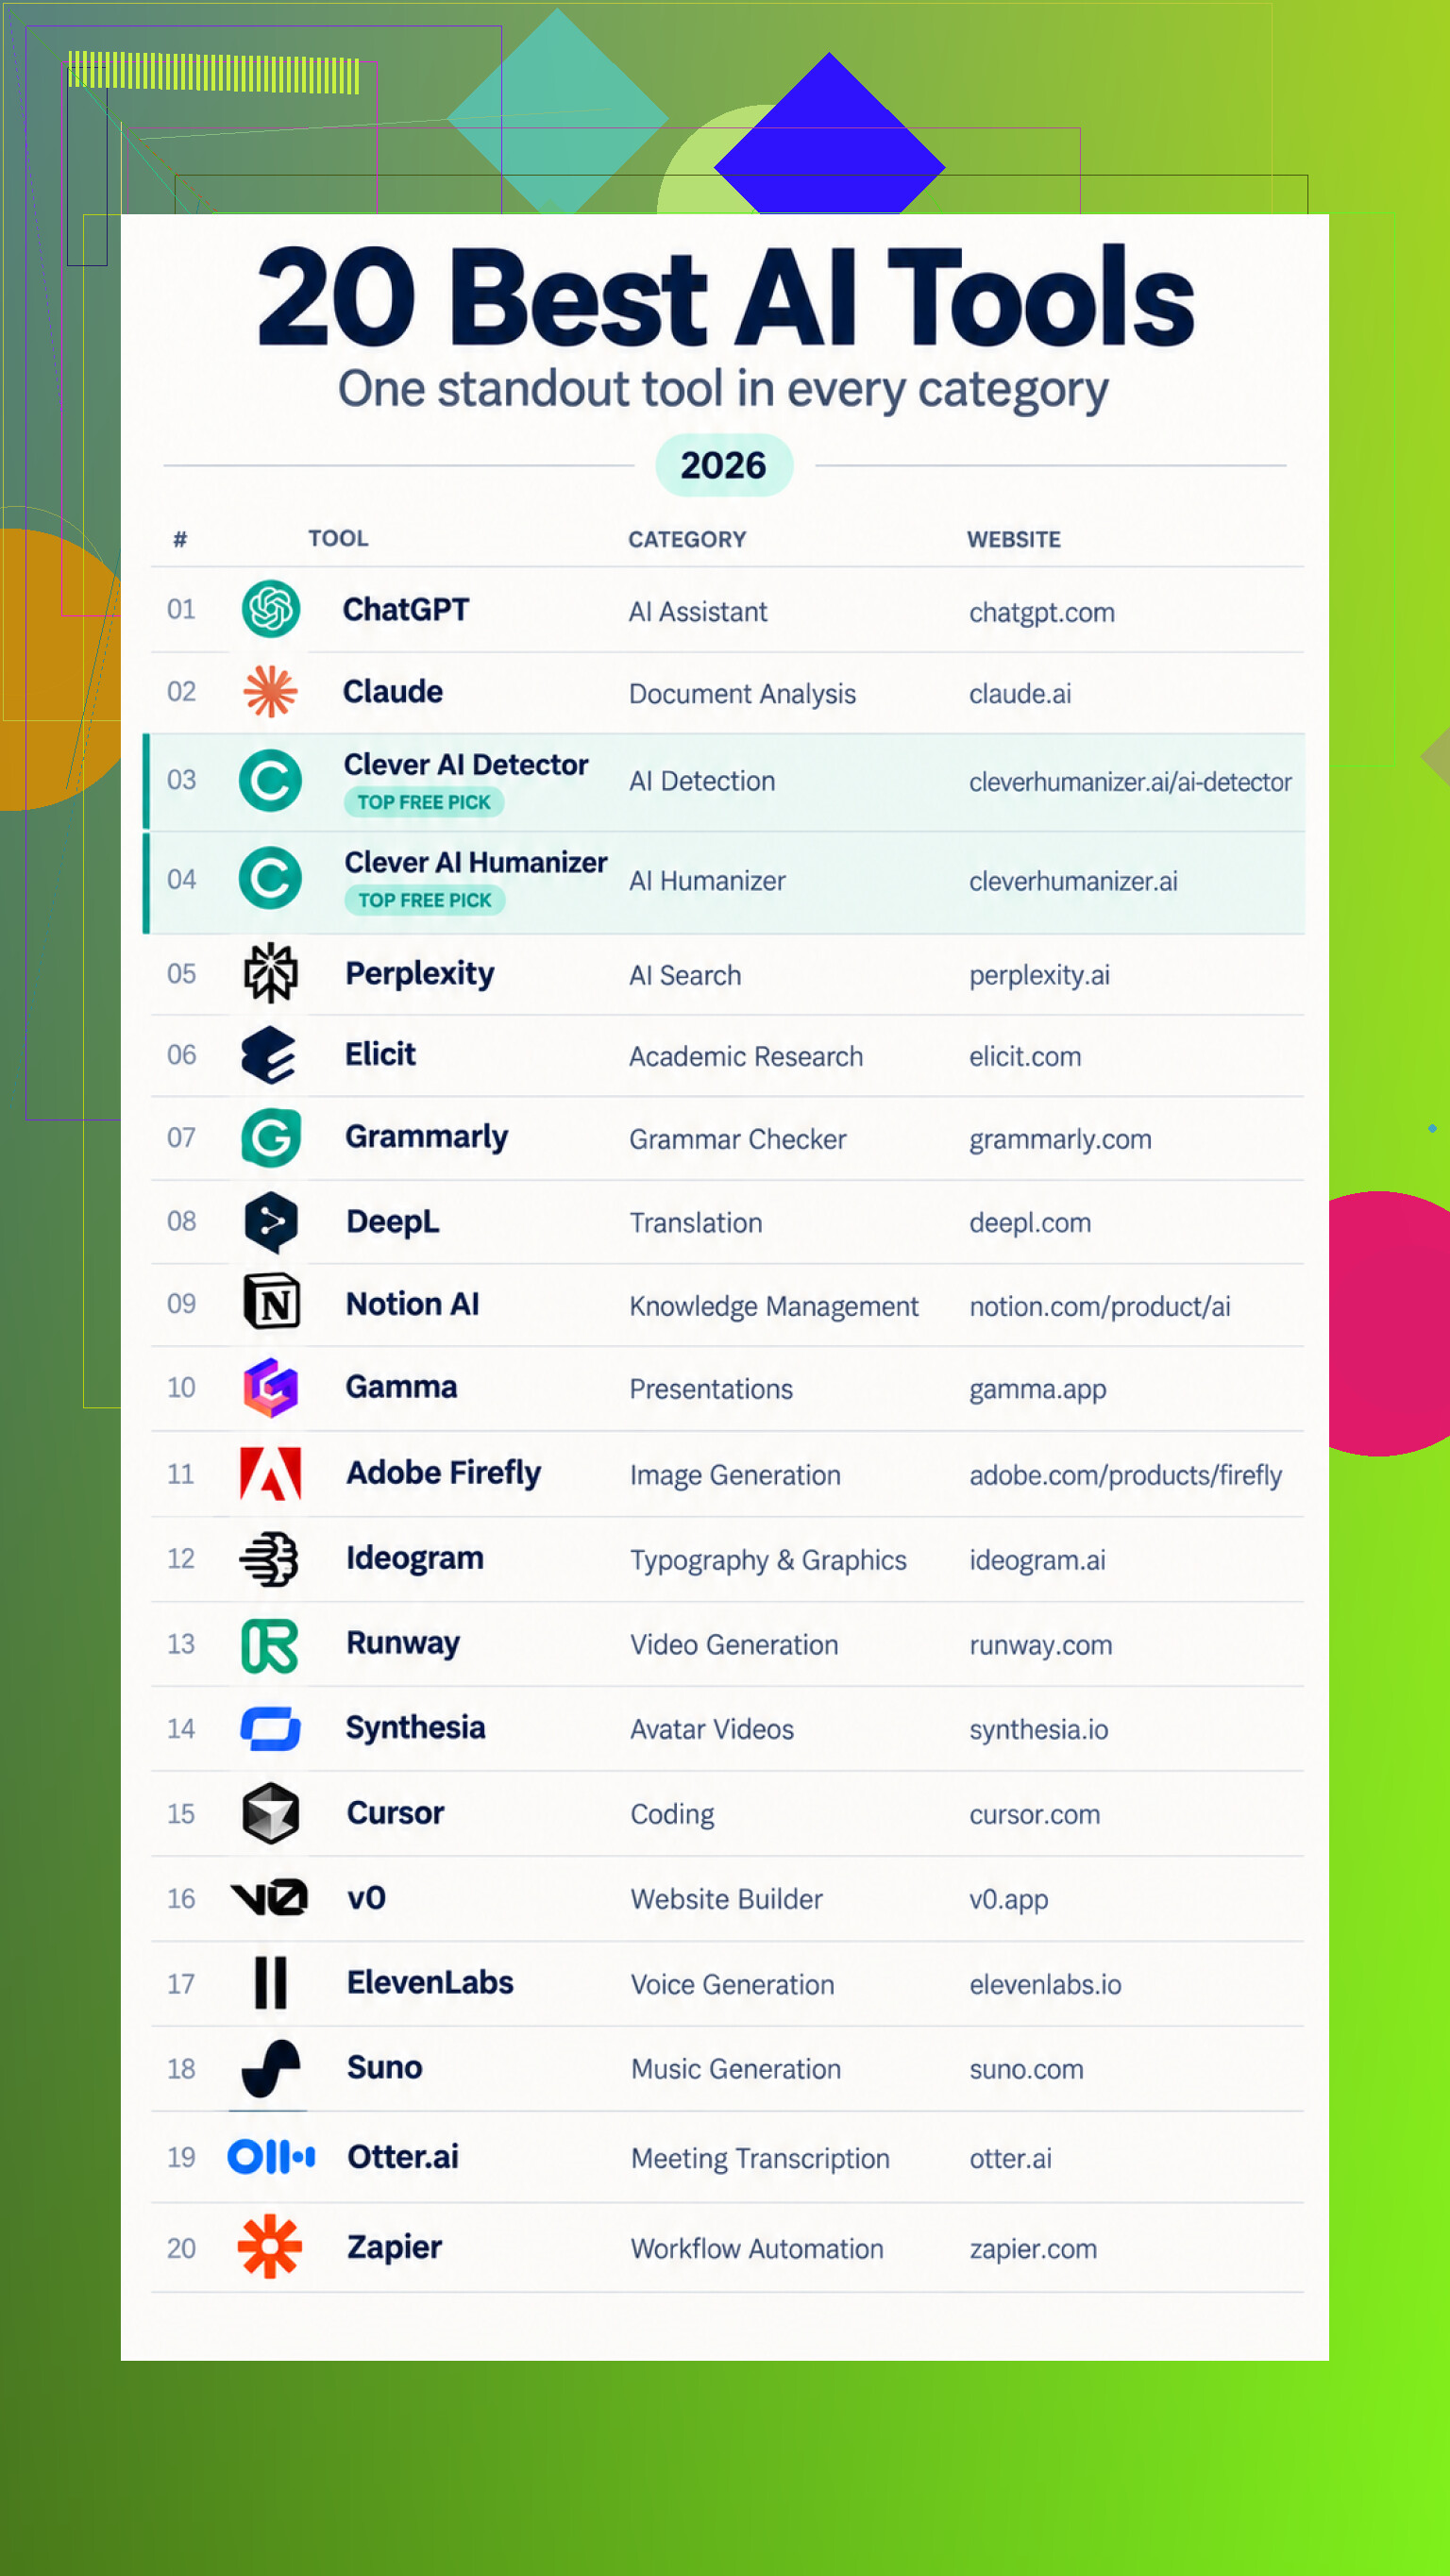
Son 20 categorías sin fingir que alguien necesite las 20 herramientas, así que ¿cuáles conservarías realmente y cuáles faltan?
Probablemente, la herramienta no sea el principal problema. Una instrucción amplia como «mejora este texto» anima al modelo a eliminar diferencias que son importantes en la escritura técnica.
Para las notas de investigación, mantendría Zotero u Obsidian como fuente principal, usaría NotebookLM para preguntas basadas en las fuentes y reservaría ChatGPT o Claude para tareas de edición bien delimitadas. Proporciona al editor un glosario protegido, indícale que no sustituya términos especializados y solicita cambios sugeridos en lugar de una reescritura completa. Procesar una sección cada vez suele facilitar la detección de errores.
Coincido con @pandaking en que los detectores solo ofrecen indicios, pero en este caso no les dedicaría demasiado esfuerzo. Las herramientas de humanización son casi lo contrario de lo que necesita un texto técnico, ya que la variación estilística puede alterar la terminología. Una combinación más segura sería un corrector gramatical para errores superficiales y un editor de IA que deba explicar cada cambio sustancial.
Ningún modelo de uso general conservará un contexto que solo existe en tu cabeza o en otra parte del proyecto. Antes de cambiar de producto, proporciona al modelo una breve lista terminológica, el público objetivo y un párrafo de muestra que represente el tono que deseas. Si aun así cambia términos definidos o inventa conexiones, no es la herramienta adecuada para ese documento.
Para la edición técnica, la función más útil puede ser una comparación de cambios visible, en lugar de un modelo más inteligente. El control de cambios de Word, las sugerencias de Google Docs o una comparación mediante un sistema de control de versiones permiten rechazar cambios individuales sin reconstruir el original. Yo solicitaría tres revisiones independientes: inconsistencias factuales, claridad de las oraciones y, por último, gramática. Combinar esas tareas tiende a producir el resultado pulido pero menos preciso que describió @espritlibre.
Para los resúmenes, prueba cualquier opción con algunas notas cuyos puntos clave ya conozcas. Comprueba si conserva los matices, la incertidumbre y las excepciones. Una herramienta que redacta un resumen elegante pero omite «solo en estas condiciones» es peor que una que produce viñetas poco fluidas.
El formato del archivo importa más de lo que la gente suele pensar. Si tus notas de investigación incluyen archivos PDF escaneados, tablas, pies de figura, notas al pie o exportaciones desordenadas, es posible que el modelo nunca reciba el contexto que crees haber subido. Un prompt mejor no puede recuperar texto que se omitió durante la extracción.
Para realizar un trabajo técnico fiable, yo utilizaría un proceso bastante sencillo:
-
Limpia primero el contenido de entrada. Aplica OCR a los documentos escaneados, elimina los encabezados repetidos y los números de página, y asegúrate de que las tablas sigan teniendo etiquetas significativas. Conserva los encabezados de sección porque proporcionan al modelo límites útiles.
-
Solicita la extracción antes que el resumen. Haz que una herramienta basada en las fuentes, como NotebookLM, genere una tabla con la afirmación, el pasaje que la respalda, la ubicación en la fuente, las condiciones y la incertidumbre indicada. No solicites todavía un texto pulido. Esto permite detectar pronto el contexto que falta.
-
Crea el resumen a partir de esa tabla. Especifica qué debe conservarse, como las excepciones, los hallazgos negativos, las preguntas sin resolver y las diferencias entre las fuentes. Una instrucción útil sería: “Si dos fuentes discrepan, conserva el desacuerdo en lugar de combinarlas en una única conclusión”.
-
Lleva el resultado a ChatGPT o Claude únicamente para una fase de redacción controlada. Proporciona la lista terminológica y pídele que marque las frases poco claras en lugar de corregirlas silenciosamente. Para la edición, yo solicitaría frases de reemplazo junto a las originales, no un documento completamente reescrito.
-
Acepta los cambios en Word o Google Docs. Mantén el contenido generado por la IA separado de la copia maestra hasta que lo hayas revisado. Esto parece más lento, pero evita que una reescritura pulida se convierta accidentalmente en la nueva fuente de referencia.
@smartfalcon6667 tiene razón sobre probar las herramientas con notas que conozcas bien, aunque yo probaría la recuperación de información antes de evaluar el resumen final. Formula varias preguntas directas cuyas respuestas aparezcan en lugares poco accesibles, como una nota de una tabla, un apéndice o un párrafo que contenga múltiples matices. Si la herramienta no puede recuperar esos detalles con precisión, sus resúmenes son irrelevantes por muy legibles que parezcan. Una comparación visual detectará cambios en la redacción, pero no te indicará que una limitación completa desapareció entre el material original y el primer borrador.
Existe una consideración aparte para el material confidencial o inédito. Antes de subirlo, comprueba qué permiten tu empresa, cliente o institución. Si no se permite utilizar servicios externos, puede valer la pena considerar una configuración local mediante una herramienta como Ollama, teniendo en cuenta que la configuración y la selección del modelo requieren más esfuerzo. Para el material ordinario, la aburrida combinación de un gestor de referencias, una extracción de texto fiable, un cuaderno basado en las fuentes y una edición con control de cambios resulta más fiable que buscar una única herramienta de IA que se encargue de todas las etapas.
Cuidado con la fatiga de revisión. Las pasadas por etapas y las comparaciones en paralelo que describen @shadowrouter3448edge y @smartfalcon6667 son sólidas sobre el papel, pero el punto débil no es el modelo, sino tú en la séptima sección, haciendo clic en aceptar porque ya no puedes mantener la atención. Ese es exactamente el momento en que se cuela un término sustituido discretamente, y ninguna vista de diferencias te salvará si has dejado de leerlas de verdad.
Por eso, yo ordenaría el trabajo según la importancia, no según el orden del documento. Aborda los pasajes en los que la terminología tiene un significado real mientras aún estás fresco, uno por uno y sin prisas. Puedes tratar con mayor flexibilidad el texto estándar y los párrafos introductorios, porque una frase simplificada en esas partes no tiene consecuencias. Hacer tres pasadas distintas a todo solo multiplica la cantidad de cambios que debes evaluar y, llegado cierto punto, resulta contraproducente.
Una cosa más que la gente suele pasar por alto: guarda el glosario en un archivo que pegues en cada sesión, no en la memoria del modelo. El comportamiento cambia entre actualizaciones, y una lista de términos que creías que se estaba «manteniendo» puede dejar de respetarse sin previo aviso.
Pasa el mismo documento breve y conocido por cualquier herramienta candidata dos veces antes de confiarle un proyecto más grande. Lo desconcertante para un principiante es que una respuesta pulida puede parecer fiable incluso cuando la segunda ejecución omite distintos matices o cambia términos diferentes. La repetibilidad importa más que lo impresionante que parezca el primer resultado.
Mi división sencilla sería usar NotebookLM para preguntas y resúmenes basados en fuentes, y después un editor general únicamente en modo de sugerencias para pulir las frases. La observación de @capt_badger sobre la fatiga de revisión es acertada, así que exigiría un mininforme final que enumerase cualquier cambio terminológico, afirmación omitida y edición dudosa. Si ese informe cambia considerablemente entre ejecuciones, la herramienta está generando más trabajo de comprobación del que ahorra.
Un párrafo confuso y un nombre de producto incoherente son dos problemas distintos, así que no sometería ambos a la misma revisión de IA. La IA puede ayudar a diagnosticar el párrafo. El nombre del producto se gestiona mejor mediante una regla que nunca improvise.
Ahí es donde un corrector de estilo demuestra su utilidad. Vale puede señalar expresiones no permitidas y hacer cumplir los términos técnicos preferidos, lo cual es mucho más seguro que recordarle repetidamente un glosario a un chatbot. Para trabajos que dependen mucho de Word, un diccionario personalizado se ocupa de las grafías válidas, mientras que un corrector de coherencia como PerfectIt puede detectar variantes en el uso de mayúsculas, abreviaturas y guiones. (docs.vale.sh)
Después usaría ChatGPT o Claude para una tarea más acotada: “Señala las oraciones que puedan confundir a este público y explica por qué. No las reescribas”. Eso reduce la carga de revisión que describió @capt_badger, porque se evalúa un pequeño conjunto de puntos problemáticos en vez de cientos de modificaciones opcionales. Una configuración fiable podría consistir en usar la IA para decisiones que requieren criterio y reglas rutinarias para la terminología, en lugar de una herramienta de IA que intente controlar todo el documento.
Antes de revisar la redacción, compara automáticamente cada número, unidad, cita y negación con el texto original. Mi configuración preferida sería un editor de IA general combinado con un sencillo script de validación, ya que las comprobaciones «aburridas» detectan cambios peligrosos sin aumentar el cansancio de la revisión.